Generative AI

从机器学习,到计算机视觉,再到医学图像分析。

Fengming Lin研究草稿 · v82026年10月22日8个维度 · 27个子项
浏览知识体系阅读论文LaTeX
摘要
生成模型的名称混合了操作、条件、数据范式和表征。我们将视觉生成组织为八个可组合坐标和 27 个选定子项,并从机器学习、计算机视觉和医学影像三个层面逐一解释。固定检索式的 arXiv 文献框架包含 25,056 条记录,覆盖 2018 年至 2026 年(截至当前);另设目的性选集,包含 60 个来源家族,均按记录的深度查验。每个子项的二十篇代表性出版物提供了 540 个时间线位置,对应 383 篇不同出版物,而非 540 次全文审阅。在呈现完整分类体系后,我们综合分析词汇轨迹、跨坐标共提及和逐来源验证。证据区分了对动作条件生成日益增长的关注与已证实的动作有效性、联合输出一致性与独立真值,以及大规模合成队列与目标人群支持。选定的医学工作流凸显了测量保真度、诊断相关结构、治疗相关量和经验证的模拟终点的重要性。随后提出四项面向医学的机会,围绕选择性决策可靠性、经独立检验的联合动力学、尾部风险虚拟队列,以及以动作为依据的观测模型展开。每项均明确已有近邻工作、必需的对照方法、终点和停止条件。这一研究议程优先追求经验证的下游改进,而非更换模型家族或追随关键词数量。

范围与方法

01 / 07
本综述的研究对象是视觉生成,而非生成式 AI 的所有用途。我们将机器学习表述与计算机视觉(CV)任务及医学影像应用联系起来,涵盖合成、转换、编辑、修复、测量重建和时序生成。文本作为条件或配对输出出现;通用语言、音频和代码生成不属于核心范围。现有视觉与医学综述以及作为结构参照的文献提供了互补的覆盖[1, 2, 3]。我们的目的在于解释各项任务的含义,以及什么证据能够使后续研究具有价值,而不是罗列模型名称或预测某一会议或期刊是否会录用。

文献发现、量化框架与证据筛选

三类文献集合不得混为一谈。多来源发现档案包含 128,499 条来源记录、经保守去重得到的 124,215 个文献族,以及 58,516 个自动筛选候选;它们并非人工纳入的论文。定量分析则采用一次冻结的视觉任务 arXiv 查询:2018–2025 年的 18,037 个唯一 ID 来自 35 个经哈希校验的页面,2026 年的 7,019 个 ID 来自另外八个页面,总计 \(N=25,056\)。快照于 2026 年 10 月 21 日 15:00 UTC 完成;返回记录中的 2026 年发表日期截至 10 月 20 日。类别和短语限制、索引延迟以及研究者是否使用 arXiv 都限制了覆盖范围。此外,定性证据核查采用了 60 个目的性选取的文献族,涵盖机器学习基础、CV 方法、医学近邻研究、临床研究及指南。这些集合均不代表对期刊或会议文献的完整覆盖。
核查深度始终明确标示。在 60 个文献族中,我们核查了其中 54 个全文中的部分方法、结果或局限性段落。另有两篇综述接受了范围核查,用户提供的参考文献接受了结构核查,一项临床 MRI 来源接受了经索引定位的主要章节核查,一项 FDA 来源接受了官方适用范围核查,一项染色近邻研究仅核查了摘要。这并不意味着对每个来源进行了从头到尾的全文阅读。定向检索将任务同义词与验证、队列、运动、临床及对照相关术语组合,随后核查直接近邻研究和相反证据。即使合并了 arXiv 与期刊版本的别名,各版本及其检索哈希仍分别保留。额外的对应关系示例另有来源与核查深度日志;证据提取由一名使用 Codex 辅助的审阅者完成,而非独立的临床裁定。
25,056固定检索式下的题名与摘要记录
383时间线中的不同论文
540论文与子任务的对应位置
54代表来源的全文选段核查

词典标注、趋势与敏感性分析

相关性审计表明,不宜将过滤后语料中的占比解释为领域占比。历史版本的 102 条规则系统在 18,037 条记录中保留了 12,237 条,排除了 5,800 条。以 20261021 为随机种子,按早期与晚期、保留与排除的分层,在每层核查 24 篇的标题和完整摘要。保留记录中的相关篇数分别为 19/24 和 20/24,排除记录中分别为 6/24 和 12/24,其中一条早期排除记录的相关性尚不确定。这些条件计数同时揭示了混入不相关研究和遗漏相关研究的问题,并非基于金标准的准确率估计。敏感性分析针对 2018–2025 年这些完整年份,比较了完整查询框架、规则保留记录、仅标题编码以及排除标题含综述标识记录的情形。我们不声称开展了独立的 2026 年相关性审计,也不声称验证了各标签的精确率与召回率。
图中的轨迹衡量加权词汇强度,标题中的计数则统计匹配次数。令 \(b_{ij}\) 表示概念 \(j\) 在标题与摘要中的二元匹配。将历史权重冻结为
\[d_j=1+\ln\frac{18,037+1}{\mathrm{df}_{j,2018:2025}+1},\quad z_i=\frac{b_i d}{\lVert b_i d\rVert_2},\quad I_{jy}=\frac{1}{N_y}\sum_{i:\,\mathrm{year}(i)=y}z_{ij},\]
未匹配记录取 \(z_i=0\)。全部 102 个概念均参与归一化,而非仅使用展示的 27 个概念。对 2026 年应用相同的 IDF,便可保留历史权重。年度分母包含所有查询返回的记录,而不只是匹配记录。末端虚线和空心标记表示 2026 年截至当前日期的数据(YTD),未作全年化换算。第4节的共同提及分析报告其自身的条件分母;它并不衡量方法采用、因果依赖关系,也不是基于相同日历时段的增长估计。

代表论文历史与阅读顺序

历史脉络用于确立里程碑,而非给出全球被引次数前 20 名。27 个子项各包含 20 篇不同的代表性论文,依据方法相关性、能力覆盖及近期进展选取:共计 540 次归属,涉及 383 篇不同出版物。这里进行的是元数据及标题与摘要核查,而非另行完成了 383 篇全文评审。在可获得时,日期采用经核实的 arXiv v1 提交日期,例外逐一记录;这并不排除存在更早的项目或 OpenReview 发布。时间线覆盖 2018–2026* 年,截至 10 月 22 日。论文按时间顺序等距排列,使用黑色箭头,高度按 \(-1,+1,-2,+2\) 的模式循环;年份间隔被有意设为非均匀,不用于编码经过的时长。更早的基础工作保留在正文中。同一论文在多个子项中出现时,均对应同一条参考文献。
本文先给出完整的八坐标总览,再按坐标顺序介绍全部 27 个子项的解释和历史脉络。此后才综合跨维度证据、考察选定的医学需求并推导研究机会。对应关系图描述的是共同表述和示例性应用,而非经测量确认的机器学习到临床的转化流程。其中的“需求/检验”陈述规定了评估要求,并非声称每个示例都已实现这些要求。

八维27项总览

02 / 07
应将模型名称理解为多个坐标的组合。图1将八个一级组与 27 个编号子项对齐。例如,少样本文本条件纹理合成结合了数据范式、条件、对象和操作;它们并不是四个相互竞争的任务。图谱在每个面板中保留一条汇总轨迹,并引入下一节将展开解释的术语。
八个可组合维度与27个子项趋势
图 1 · 八个可组合维度与27个子项趋势SVG
各一级组回答不同的问题。操作规定改变什么;条件规定提供哪些信息;数据范式规定目标数据预算;组织方式规定任务或输出之间的关系;对象规定生成什么;时间结构规定跨时间或动作的依赖关系;机制规定如何学习分布或从中采样;要求规定必须保留和检验什么。27 个叶节点是选定的术语锚点,而非穷尽式划分。一篇论文可以归入多个叶节点,而大多数有用的实验会跨越多个坐标。表1明确说明了解读约定,不再重复图谱中的计数。
坐标解读约定明确了比较两种方法时究竟是哪项假设发生变化。最后一列列出常见的类别混淆,否则这些混淆会使表面上的进展难以解释。

表 1 · 八维阅读与比较契约

坐标 需回答的问题 不可据此推断
任务操作 创建、改变或恢复什么? 每个合理样本都恢复了某个已观测个案。
条件与控制 提供了哪些输入,可以引导什么? 提供条件就能保证选择性控制。
数据与适配范式 允许使用哪些真实样例和预训练资源? 目标样本少就意味着总训练量少。
任务组织 哪些内容共享学习,或构成耦合样本? 多模态、多任务和联合是同义词。
生成对象 强度、外观还是几何? 3D 强度体积就是表面模型。
时序结构 什么依赖于时间、历史或动作? 平滑性即可确立动力学有效性。
建模机制 采用什么目标函数、概率路径和采样器? 骨干网络的选择定义了任务。
要求与评估 必须检查哪些量、预算和失败? 漂亮的平均分数能为所有用途背书。
分布条件与测量条件意味着不同的义务。无条件采样建模的是 \(p_\theta(x)\),语义条件建模的是 \(p_\theta(x\mid c)\)。而一次特定测量约束的是一个特定对象:
\[y=A(x)+\epsilon,\qquad p(x\mid y,A)\propto p(y\mid x,A)p(x).\]
一个提示词可以对应许多合适的图像;患者数据则指向一个潜在的具体病例。算子、噪声和先验都会影响重建。确定性的编码器—解码器不一定定义采样分布,而变分潜变量模型会显式定义它[4]。将解限制在生成器的值域内也可能引入表示误差[5]。概率记号描述的是预期目标,并不证明实际采样器满足该目标。
不能用一个坐标替代其缺失的相邻坐标。少样本目标域适应可能依赖大量的源域预训练[6]。纹理可能指给定几何上的表面外观、组织外观,也可能指一种定量影像特征。Transformer 是骨干网络,本身并非分布学习目标;动态输出也不一定是动作模型。这些区分可避免将表示形式或术语的变化误认为新任务。下一节严格按 01–27 项的顺序展开,在每组各自的历史脉络之前给出对应关系图。

逐维逐项理解生成模型

03 / 07
每组先给出一张共享的机器学习—CV—医学对应图,再介绍该组的编号子项。对应图提供示例和不变量;历史脉络提供标有日期的里程碑。在进行任何跨维度综合或讨论研究机会之前,本节先介绍全部 27 项。

任务操作

操作说明创建、改变或恢复什么。这六行区分了新实例采样、保持身份的转换、局部编辑、缺失内容恢复、测量反演和序列生成。即使同一模型族支持多种操作,它们的条件和可接受误差也各不相同。
ML–CV–医学影像对应关系01–06
任务操作
图 2 · 任务操作SVG

01 · 新样本合成

合成采样一个实例,而不是恢复某个特定的已观测个体。文生图模型创建与描述相容的场景;医学体数据生成器则在给定条件下创建一种可能的解剖结构。输入可以仅是噪声,也可以是噪声与元数据的组合,输出则可以是像素、体素、几何或纹理。潜空间扩散是代表性的视觉实现[7]。在医学中,MAISI 以身体区域和间距为条件进行体数据生成,并提供掩膜引导或肿瘤填充路径[9]。纹理是另一种对象坐标:Text2Tex 在已给定的网格上生成表面外观,因此它并未展示联合几何恢复[8]。基本问题是条件控制哪些属性、哪些变化仍可自由发生,而不只是渲染结果看起来是否逼真。
当合成产生的变化能够支持真实下游需求时,合成才有用。训练增强需要在留出的真实病例上获得改进,而不只是对生成标签的性能;队列构建需要有代表性的覆盖,而不只是样本数量。MAISI 包含外部 autoPET 图像分布评估,但这并非独立诊断终点或隐私审计[9]。MAISI-v2 结合了校正流、区域特定损失以及改变的数据/训练条件,因此不能将所有差异都归因于某一个目标函数[27]。条件解剖结构与罕见先天性拓扑也已有实现[28, 29]。负责任的比较应在匹配资源的条件下衡量条件准确性、尾部覆盖、记忆化风险和真实任务效用。如果重采样或统计形状模型已能提供所需变化,更大的学习式生成器就必须证明其额外假设和成本合理。
图3将 20 篇代表性合成文献置于统一的 2018–2026* 年时间窗口中;箭头对应参考文献表中的条目[30, 31, 32, 33, 34, 35, 36, 37, 38, 7, 39, 40, 41, 42, 43, 44, 45, 46, 47, 48]。统一的选择与日期约定见第1节。
代表论文时间线20 篇论文
新样本合成 · 20 篇论文 · 2018–2026*
图 3 · 新样本合成 · 2018–2026*SVG

02 · 跨域转换

转换改变域,同时尝试保留相关对象。将标签图变为照片改变的是外观;将 MRI 变为合成 CT 改变的是成像表示;虚拟染色将未染色测量映射为类似染色的对比度。配对转换从对齐样例中学习,而非配对转换在额外约束下从各域的边缘分布样本中学习[10, 11]。这一区别至关重要:循环一致性可以支持可逆映射,却不能唯一确定在医学上正确的逐受试者映射。虚拟染色展示了真实的医学转换任务,其中配准和组织制备会影响参照配对[13]。因此,应将输出描述为特定采集与训练方案下的条件估计,而不是对目标模态可能揭示的每一种生物量进行了一次新测量。
保留约定决定评估方式。对于合成 CT,密度和几何误差通过剂量计算与定位产生影响;对于染色,它们通过结构和诊断观察产生影响。AortaDiff 已将对比度转换与分割及临床可解释测量相耦合,因此任务感知的联合转换并非尚未涉足的想法[49]。其预印本评估还存在 ROI、对齐和派生参照方面的局限,这些都应明确保留。SynthRAD2025 报告区分图像、几何和剂量标准,并展示为何排名依赖终点[50]。当罕见结构会改变治疗计划时,非配对逼真性或平均相似度并不足够。应将转换与当前临床工作流程比较,包括非生成式替代方案;失败时应触发明确的后备方案,而不是隐藏在漂亮的平均分中。
图4将 20 篇代表性转换文献置于统一的 2018–2026* 年时间窗口中;箭头对应参考文献表中的条目[51, 52, 53, 54, 55, 56, 57, 58, 59, 60, 61, 62, 63, 64, 65, 66, 67, 68, 69, 70]。统一的选择与日期约定见第1节。
代表论文时间线20 篇论文
跨域转换 · 20 篇论文 · 2018–2026*
图 4 · 跨域转换 · 2018–2026*SVG

03 · 定向编辑

编辑要求在现有实例的基础上进行受控改变。诸如改变对象颜色的指令并不是无条件采样;原始图像提供了身份及非目标属性。InstructPix2Pix 从生成的指令—编辑三元组中学习,并报告了非预期改变、隔离目标和视角方面的困难[14]。在医学中,数字同胞已经能够创建局部解剖变化,并评估形态与拓扑[15]。这里的有用输出往往是一组用于敏感性分析的受控替代方案,而不是在临床上被断言为患者未来状态的结果。必须规定可编辑区域、必要不变量、允许的拓扑变化,以及编辑幅度的含义。视觉上很小的改变,对下游测量仍可能很大,尤其是在病灶、瓣膜或血管边界附近。
反事实图像不会自动成为具有因果意义的治疗反事实。如果明确规定仿真器与干预,经过编辑的解剖结构可以支持计算实验,但仅凭视觉合理性无法辨识患者对治疗的响应。分布层面的编辑也不能证明所有非目标生理特征都得到保留。恰当的检验应比较编辑前后的独立测量,对边界情况进行压力测试,并量化所请求区域之外的附带改变。当所需变化较简单时,经典参数化变形或重采样可能是强对照。学习式编辑器的贡献应是新近得到支持和验证的一类变化,或更好的误差—成本权衡,而不是给已有解剖操作换个标签。这一区分既保持受控敏感性研究的价值,又避免夸大生物学因果关系。
图5将 20 篇代表性编辑文献置于统一的 2018–2026* 年时间窗口中;箭头对应参考文献表中的条目[71, 72, 73, 74, 75, 76, 77, 78, 79, 80, 14, 81, 82, 83, 84, 85, 86, 87, 88, 48]。统一的选择与日期约定见第1节。
代表论文时间线20 篇论文
定向编辑 · 20 篇论文 · 2018–2026*
图 5 · 定向编辑 · 2018–2026*SVG

04 · 修复与补全

修复在补偿退化的同时保留已观测场景。去噪、去模糊、着色和缺失区域填充的区别在于,答案中有多少内容是可辨识的。Palette 在这类任务中的多个任务上采用共享的图像条件扩散表述[16];如果没有共享的任务训练和评估,仅有多个条件本身并不能证明多任务学习。DDRM 通过算子结构,在多个线性逆问题中复用图像先验[17]。医学示例包括显微图像修复和 MAISI 肿瘤填充[18, 9]。填充区域可能是合理的仿真对象,而非真实隐藏解剖结构的证据。任务描述必须说明目标是回顾性恢复、前瞻性诊断、合成增强还是实验性扰动,因为外观相同的输出可能具有截然不同的可接受失败模式。
在未观测区域,强先验可能成为负担。可见像素上的残差较小,不能说明缺失结构是否正确;多个合理样本也不会自动量化经过校准的不确定性。已有工作已将先验引起的幻觉与普通重建误差区分开,并开发了以分布为参照的幻觉指标[89, 18]。后者依赖明确的参照和近似假设,而不是普适的真值判定器。因此,评估应区分受测量支持的细节、存在歧义的补全,以及错误却令人信服的结构。对于临床用途,问题是这些歧义是否改变诊断或定量终点,以及系统能否拒绝填充。确定性修复仍是不可或缺的对照:这种基于操作的分类体系包含此类对照,但不声称每个去噪器都是随机生成模型。
图6将 20 篇代表性修复/填充文献置于统一的 2018–2026* 年时间窗口中;箭头对应参考文献表中的条目[90, 91, 92, 93, 94, 95, 96, 97, 98, 99, 16, 100, 101, 102, 103, 104, 105, 106, 107, 108]。统一的选择与日期约定见第1节。
代表论文时间线20 篇论文
修复与补全 · 20 篇论文 · 2018–2026*
图 6 · 修复与补全 · 2018–2026*SVG

05 · 测量约束重建

重建使用指定的前向模型和一次特定测量。CT 投影数据与 MRI k 空间通过公式2约束潜在对象;它们并非仅仅是生成外观相似图像的提示。生成式压缩感知明确考虑表示误差,而 DPS 使用去噪估计近似含噪似然[5, 19]。医学中的基于分数的重建展示了在不同采样算子下复用无条件先验[20]。在所核查的研究中,CT 投影与单线圈 MRI 测量由图像数据模拟得到。这些实验考察了算子变化,但并不构成前瞻性的扫描仪或诊断验证。准确的报告应区分真实源图像、模拟测量、真实采集检验、外部患者和临床阅片者,而不是将它们一概归为“真实医学数据”。
忠实性所需的不只是精确的数据拟合。噪声与模型失配可能使严格拟合并不理想,而较小的数据残差不能证明算子约束不足的成分正确[89]。即使观测更多,生成器值域偏差也可能持续存在[5],后验样本的多样性还可能混合模型、数值和观测效应。更有力的实验会固定原始数据划分,比较具有竞争力的非生成式方法与生成式基线,并在现实的计算预算下测量预先规定的病灶、定量或阅片者终点。已有研究使用扩散后验样本探索主动采集[109];新颖性必须超越仅仅选择下一个视角。只有在计入失败病例和重新采集时间等总负担后仍具有优势,并能够支持经过校准的决策、拒绝或额外测量时,不确定性才有实际价值。
图7将 20 篇代表性测量反演文献置于统一的 2018–2026* 年时间窗口中;箭头对应参考文献表中的条目[110, 111, 112, 113, 114, 115, 20, 17, 116, 19, 117, 118, 119, 120, 121, 122, 123, 124, 125, 126]。统一的选择与日期约定见第1节。
代表论文时间线20 篇论文
测量约束重建 · 20 篇论文 · 2018–2026*
图 7 · 测量约束重建 · 2018–2026*SVG

06 · 时序生成

时间引入了多个不同问题。无条件视频生成一个序列;插值填补缺失时刻;预测以过去为条件;动作条件生成还接收对采集或环境的干预。Video Diffusion 和 Genie 分别代表联合视觉序列与交互动力学[21, 22];4D-fy 则加入动态三维表示,并使用互补的图像和视频监督[23]。医学案例包括 CHeart 的心动周期内解剖结构、Cardiac Mesh Flow 的动态网格,以及探头运动下的超声视图[24, 25, 26]。心动周期不是纵向疾病进展,自回归的“因果”架构也不是治疗效果模型。同样,平滑的渲染网格不会自动成为经测量的位移场。每种时序用途都必须规定条件历史、预测时域、动作语义和独立参照。
时序有效性需要能够揭穿表面指标的阴性对照。Cardiac Mesh Flow 的消融表明,静态心脏也能获得很强的周期一致性,因此端点一致不足以验证运动[25]。CHeart 的稠密时序解剖结构依赖经过处理的分割标签,而非独立局部运动真值[24]。SonoWorld 已将超声生成建立在具有度量尺度的姿态之上,EchoWorld 则研究用于探头引导的预测表示[26, 127];所核查的两项评估均未建立独立的真实机器人临床策略迁移试验。接触力、变形、生理状态和扫描仪设置都可能使仅基于姿态的观测模型失效。检验应包括静态输出、条件打乱、非重放动作,以及局部运动或控制终点。重要的进展不是更长或更平滑的视频,而是能够证明时间、动作与下游量之间存在正确关系。
图8将 20 篇代表性时序生成文献置于统一的 2018–2026* 年时间窗口中;箭头对应参考文献表中的条目[128, 129, 130, 131, 21, 132, 133, 134, 135, 136, 137, 138, 139, 140, 141, 142, 143, 144, 145, 146]。统一的选择与日期约定见第1节。
代表论文时间线20 篇论文
时序生成 · 20 篇论文 · 2018–2026*
图 8 · 时序生成 · 2018–2026*SVG

条件与控制

条件规定所提供的信息;控制则考察所要求的属性是否能够可靠地改变。文本只是条件的一种,并不等同于条件化。模型即使使用掩膜或文字,仍可能无法保留未要求改变的内容。这些区别解释了下方三行的含义。
ML–CV–医学影像对应关系07–09
条件与控制
图 9 · 条件与控制SVG

07 · 条件生成

条件生成。条件生成考察提供信息时输出如何变化,而不是有多少训练数据可用。在机器学习中,条件选择一个分布:相同类别或上下文仍可对应许多有效样本。SPADE 通过语义布局合成场景,将这一思想引入 CV。MAISI 提供了医学对应案例,以器官分割为条件、以可配置体素间距生成合成三维 CT。期望保持的不变量是与所提供解剖结构的一致性;未指定的外观仍可变化。文本条件是一个特例,而可控性还进一步考察能否可靠地引导特定变化。建议的检验包括条件一致性、多样性和解剖合理性,它们并非已获保证的属性。条件输入不能证明患者身份、病理真值、隐私或临床收益。时间线与示例依据以下来源[52, 30, 150, 151, 147, 152, 37, 97, 16, 7, 39, 153, 41, 148, 154, 149, 155, 9, 156, 157]。
代表论文时间线20 篇论文
条件生成 · 20 篇论文 · 2018–2026*
图 10 · 条件生成 · 2018–2026*SVG

08 · 文本条件生成

文本条件生成。文本条件生成以语言作为条件,因此可以与其他条件模态和数据范式结合。在机器学习中,文字规定所需属性和关系,但生成器必须将其转换为视觉内容。Imagen 为文生图扩散提供了 CV 锚点,物体数量、颜色和关系可作为有用的教学检验点,而非保证成功的能力。RoentGen 使用胸部 X 线片及报告适配预训练潜空间扩散模型,再根据医学语言提示生成 X 线片。建议的检验应区分提示遵循程度与图像逼真性,并独立评估所呈现的征象和解剖结构。请求某个诊断既不能证明输出正确呈现了该诊断,也不是患者的真实情况。这些由摘要支持的示例确立的是生成能力,而不是完整的病理控制、患者保留或临床证明。时间线与示例依据以下来源[151, 152, 37, 158, 7, 39, 153, 40, 41, 42, 148, 46, 159, 47, 160, 161, 162, 163, 156, 157]。
代表论文时间线20 篇论文
文本条件生成 · 20 篇论文 · 2018–2026*
图 11 · 文本条件生成 · 2018–2026*SVG

09 · 可控生成

可控生成。可控性是一种引导目标,而条件化描述提供给生成器的信息。有用的机器学习检验是在固定其他输入、并在有意义时固定随机种子的情况下,改变一个所请求因素;仍必须检查输出是否出现耦合变化。ControlNet 利用姿态、边缘或深度条件,为预训练文生图扩散模型添加经过训练的空间控制器。MAISI 记载了用于 CT 合成的器官掩膜条件,提供的是范围较窄的解剖控制示例,而非疾病干预模型。建议的检验应量化对掩膜改变的响应,以及其他位置的非预期改变。冻结的基础生成器或解剖控制,都不意味着免训练的控制学习、因果辨识、患者身份保留或临床有效性。这些坐标可以与文本条件重叠,也可以与低数据适应或大规模训练重叠。时间线与示例依据以下来源[147, 71, 72, 73, 74, 164, 153, 78, 14, 154, 165, 149, 155, 83, 166, 167, 168, 9, 169, 170]。
代表论文时间线20 篇论文
可控生成 · 20 篇论文 · 2018–2026*
图 12 · 可控生成 · 2018–2026*SVG

数据与适配条件

预算必须分别说明目标样例、源域预训练和推理时拟合。少样本限制目标支持集;零样本或免训练复用省去某个指定的拟合阶段;数据效率则比较不同真实数据预算下的性能。它们均不能单独证明总计算量较低。
ML–CV–医学影像对应关系10–12
数据与适配条件
图 13 · 数据与适配条件SVG

10 · 少样本生成

少样本。少样本生成限制的是某个指定目标(例如受试对象或域)的样例数量,而不是曾经使用过的全部数据。在机器学习中,适应将已学习的先验迁移至这个小型支持集;其他方法也可以在不更新权重的情况下以支持集为条件。DreamBooth 通过在少量主体照片上微调预训练文生图模型,展示 CV 个性化。EndoFSA 记录了一个医学案例:先在大量正常胶囊内镜图像上预训练生成器,再通过受限参数更新使其适应样本稀缺的异常域。这些是生成的域样例,而不是对某个特定患者病灶的重建。建议的检验包括未见患者的病灶审查、多样性和记忆化审计。确切的医学样本数与独立临床性能仍需进一步证据;仅有少量可训练参数不能证明少样本学习。时间线与示例依据以下来源[174, 175, 176, 6, 177, 178, 171, 179, 180, 181, 182, 183, 184, 185, 186, 187, 188, 189, 170, 172]。
代表论文时间线20 篇论文
少样本生成 · 20 篇论文 · 2018–2026*
图 14 · 少样本生成 · 2018–2026*SVG

11 · 零样本/免训练

零样本/免训练。这一坐标关注不针对目标条件或采集算子拟合生成器权重的复用。它不同于对未见类别进行语义零样本识别。没有目标标签也不意味着没有预训练,或没有目标模态图像。在机器学习中,已有先验在推理时与新条件结合。RePaint 通过改变反向采样迭代,而不是重新训练网络,将已训练的无条件扩散模型变为图像补全器。在医学中,Score-MRI 将在幅值图像上训练的分数先验与适用于不同采样模式的数据一致性步骤结合。其免训练之处在于针对不同采集方式复用,而不是凭空学习 MRI 解剖结构。建议的检验应评估测量残差和经独立核查的解剖结构。推理中的投影或潜变量优化仍会产生计算开销;与已测数据一致不能验证未被测得的病灶。时间线与示例依据以下来源[76, 64, 115, 100, 17, 78, 19, 80, 82, 117, 165, 139, 83, 190, 166, 167, 168, 169, 191, 192]。
代表论文时间线20 篇论文
零样本/免训练 · 20 篇论文 · 2018–2026*
图 15 · 零样本/免训练 · 2018–2026*SVG

12 · 数据高效生成

数据高效。数据效率考察能否在指定质量水平下,用更少真实样例或更少目标监督学到有用的生成能力。在机器学习中,正则化或迁移可以减少过拟合,但必须说明数据预算。ADA 通过用于有限数据 GAN 训练的自适应判别器增强,提供了 CV 锚点,涵盖从头训练和迁移。EndoFSA 展示医学目标数据复用:正常图像预训练支持适应稀缺的异常内镜图像。这是一项有文献记录的低数据设计,而非经验证的跨方法效率排名。建议的检验是在固定划分和可比预训练资源获取条件下,绘制质量、多样性和独立下游性能随真实患者数量变化的曲线。大量预训练数据应单独计数;更快的采样、更小的适配器和更多合成图像,本身都不能证明对真实数据的需求更低。时间线与示例依据以下来源[174, 175, 176, 173, 193, 194, 195, 196, 6, 197, 177, 198, 178, 171, 180, 199, 200, 201, 172, 202]。
代表论文时间线20 篇论文
数据高效生成 · 20 篇论文 · 2018–2026*
图 16 · 数据高效生成 · 2018–2026*SVG

任务组织

组织方式描述哪些部分共享学习,以及哪些输出属于同一个样本。多任务关注目标,多模态关注表示,联合生成关注相互依赖的输出。同一系统可以同时具备这三个属性;仅凭架构或通道数无法确立其中任何一种属性。
ML–CV–医学影像对应关系13–15
任务组织
图 17 · 任务组织SVG

13 · 多任务生成

多任务。多任务描述不同目标如何共享学习,而不是有多少通道进入网络。一个通用的机器学习示例是在多个条件生成目标之间共享参数,同时在共享或任务特定损失下保留针对各任务的评估。Palette 提供了 CV 实例:一个通用扩散模型处理着色、图像补全、反裁剪扩图和 JPEG 修复。在医学中,AortaDiff 将从非增强 CT 生成合成增强 CT,与管腔和血栓分割结合。因此,它也与联合生成重叠;各坐标取值并非互斥类别。图像质量以及分割或测量误差,都需要分别对照专用基线进行检验。预期保持的不变量是跨任务的解剖身份,而非像素值完全相同。仅有共享架构不能证明使用的是同一个未改变的检查点,基准性能也不能证明可以替代临床流程。时间线与示例依据以下来源[76, 16, 7, 39, 207, 208, 209, 210, 211, 203, 212, 213, 214, 215, 216, 217, 204, 218, 219, 220, 49]。
代表论文时间线20 篇论文
多任务生成 · 20 篇论文 · 2018–2026*
图 18 · 多任务生成 · 2018–2026*SVG

14 · 多模态生成

多模态。多模态生成连接语义不同的表示,例如语言和图像。在机器学习中,由文本生成图像建模的是跨模态条件分布;文本可以保持固定,而仅对图像采样。UniDiffuser 展示了 CV 中的这一区别:同一框架通过不同采样设置,支持图生文、文生图以及配对图像—文本生成。UniX 提供了医学示例,涵盖胸部 X 线片报告生成和文本引导的 X 线片合成。应检验的不变量是对所请求征象的一致性,而不是与某个患者的逐像素身份一致。多模态条件本身并不等于联合采样,多个 MRI 对比度本身也不能证明存在任意模态到任意模态的系统。必要检验包括征象层面的遗漏、矛盾及无依据细节;逼真的图像或流畅的报告不是临床证明。时间线与示例依据以下来源[37, 39, 41, 203, 221, 222, 223, 212, 224, 213, 225, 226, 227, 214, 228, 229, 217, 204, 218, 230]。
代表论文时间线20 篇论文
多模态生成 · 20 篇论文 · 2018–2026*
图 19 · 多模态生成 · 2018–2026*SVG

15 · 联合生成

联合生成。联合生成关注属于同一样本的多个输出之间的依赖关系。在机器学习中,仅学会两个合理的边缘分布并不足够:图像及其标注在共同采样时必须一致。JointNet 通过耦合 RGB 与稠密模态的扩散分支,生成相互对应的 RGB—深度输出,展示了 CV 中的这一点。MedSegFactory 提供了医学对应案例,以图像和分割掩膜两个流,在去噪过程中通过联合交叉注意力连接。耦合也可以使用共享潜变量或具有依赖关系的流水线;同时执行并不是其定义条件。必要检验应评估各个输出及其对应关系,包括边界、标签语义,以及在独立真实病例上的下游性能。联合生成的掩膜不是独立真值:两个流可能复现相同的解剖错误,仅有一致性不能证明临床有效性。时间线与示例依据以下来源[231, 232, 233, 234, 203, 235, 221, 236, 205, 237, 238, 239, 240, 229, 206, 241, 242, 243, 244, 230]。
代表论文时间线20 篇论文
联合生成 · 20 篇论文 · 2018–2026*
图 20 · 联合生成 · 2018–2026*SVG

生成对象

对象规定输出所表示的内容:强度数组、表面或某个域上的外观,或几何。三维 CT 体数据仍然是图像,而分割编码的是解剖结构。组织外观是医学中的纹理类比,而非忠实表面纹理映射的证据。
ML–CV–医学影像对应关系16–18
生成对象
图 21 · 生成对象SVG

16 · 图像

图像。图像规定生成对象,而非学习机制或任务。在机器学习中,模型采样一个数组,其值表示强度或颜色;生成可以是无条件的、有条件的,也可以是修复的一部分。StyleGAN 通过合成具有可控外观变化的人脸图像,提供了 CV 示例。MAISI 通过潜空间扩散合成三维 CT,并可使用器官分割作为 ControlNet 条件,展示医学目标。强度体数据即使占据三维空间,仍然属于图像;分割体数据编码的则是解剖标签或形状。必要检验包括解剖一致性、强度偏差、多样性和记忆化,而非仅看视觉逼真性。器官掩膜是控制信号,不是临床证据;合成 CT 不得视为实际采集的患者测量。时间线与示例依据以下来源[30, 31, 32, 33, 34, 36, 37, 38, 7, 39, 40, 41, 44, 46, 159, 47, 247, 160, 161, 219, 9]。
代表论文时间线20 篇论文
图像 · 20 篇论文 · 2018–2026*
图 22 · 图像 · 2018–2026*SVG

17 · 纹理与外观

纹理。纹理指生成的外观,可以是空间图案、网格颜色贴图或材质场。机器学习问题建模的是空间外观统计,而不只是几何。Text2Tex 是直接的 CV 示例:给定的网格与文本引导多视图扩散补全,从而构建网格纹理。网格几何是固定的承载对象;需要检验接缝和跨视图一致性。这里的医学联系明确是一种外观类比:虚拟染色使用 GAN 将无标记组织自发荧光映射为具有染色外观的显微图像。它生成的是图像外观,而不是网格的 UV 纹理。同样,MIVAE 将 MRI 外观与心脏形状耦合;这并不会使 MRI 强度变成表面材质。匹配组织学结构和疾病相关细节,需要超越视觉逼真性的独立验证。时间线与示例依据以下来源[248, 231, 249, 250, 251, 252, 253, 234, 211, 8, 236, 254, 255, 256, 257, 258, 259, 243, 260, 261, 13, 245]。
代表论文时间线20 篇论文
纹理与外观 · 20 篇论文 · 2018–2026*
图 23 · 纹理与外观 · 2018–2026*SVG

18 · 形状

形状。形状规定承载几何信息的输出,而不是某一种特定生成器。在机器学习中,学习坐标、占据值或符号距离的分布,使采样新的空间构型成为可能。PointFlow 通过建模形状分布,以及每个形状对应的点条件分布,展示了 CV 案例。其点云本身不提供三角形连接关系。CAN-FLOW 提供了医学示例:条件归一化流建模依赖元数据的心脏形状表示,并生成双心室解剖结构。它并不会仅因名称中包含 flow 就成为流匹配方法。必要检验涵盖解剖有效性、表型分布、亚组变化和几何表示约定。来自健康训练解剖结构的证据不能证明对患病解剖结构的覆盖、生理功能或仿真就绪性。外观和时序运动仍是独立但可能重叠的坐标。时间线与示例依据以下来源[262, 246, 263, 264, 265, 266, 234, 267, 268, 269, 210, 270, 271, 272, 273, 274, 275, 276, 277, 220, 28]。
代表论文时间线20 篇论文
形状 · 20 篇论文 · 2018–2026*
图 24 · 形状 · 2018–2026*SVG

时间结构

时间结构考察状态如何依赖时间和动作。带时间索引的三维对象、缺失的中间帧,以及在给定动作下的未来观测,需要不同的参照。它们可能具有相似的平滑性,但物理或控制含义各异。
ML–CV–医学影像对应关系19–21
时间结构
图 25 · 时间结构SVG

19 · 4D/3D+t

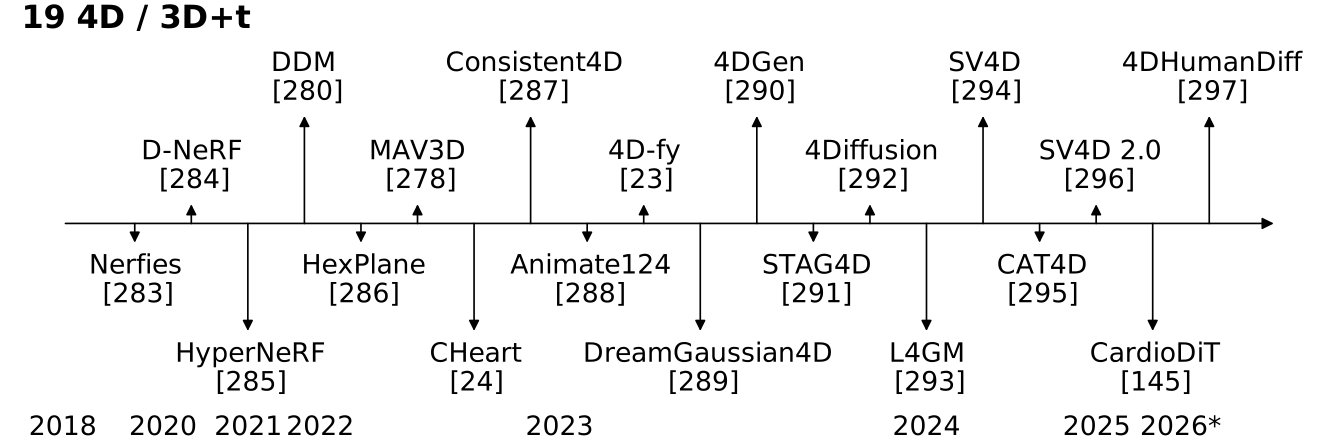
4D / 3D+t。 这一坐标关注三个空间维度是否随物理时间演化,而不是采样器是否执行了许多数值步骤。在 ML 层面,模型生成以时间为索引、彼此依赖的空间状态;相互独立的体积数据并不能构成连贯轨迹。在 CV 中,MAV3D 将文本转换为动态 3D 辐射场,可从不同视角进行渲染。在医学中,CHeart 以临床因素为条件生成心脏解剖序列。这些示例说明的是输出结构,而非某个专属模型家族,也可同时带有条件或机制标签。验证应将解剖与运动同留出的参考序列进行比较,并在适用时纳入心室容积轨迹。平滑性或合理的群体变异,并不能证明结果反映了患者实测生理、电激动,或构成有效的个体数字孪生。时间线及示例依据以下来源 [283, 284, 285, 280, 286, 278, 24, 287, 288, 23, 289, 290, 291, 292, 293, 294, 295, 296, 145, 297]。
代表论文时间线20 篇论文
4D/3D+t · 20 篇论文 · 2018–2026*
图 26 · 4D/3D+t · 2018–2026*SVG

20 · 帧插值

帧插值。 帧插值填补的是严格位于已观测端点之间的时刻;外推则预测端点之外的状态。这一 ML 问题属于以端点为条件的合成,可能存在多条合理的中间路径。FILM 是 CV 示例,即使存在大幅运动,也能合成中间图像帧。医学示例 DDM 则利用学习到的形变,在舒张期与收缩期观测之间生成中间 3D 心脏 MR 体积。因此,同一时序坐标既可描述普通图像帧,也可描述空间体积;当后者随时间演化时,它也与 4D 生成重叠。评估应留出真实采集的中间时相,检查解剖、时序与运动,而非仅对端点复现评分。插值得到视觉上平滑的心跳,并不能确定该患者实际的中间生理状态,也不能据此合理预测临床随访之间的疾病进展。时间线及示例依据以下来源 [298, 299, 300, 301, 302, 303, 279, 280, 304, 305, 306, 307, 308, 309, 310, 311, 312, 313, 314, 315]。
代表论文时间线20 篇论文
帧插值 · 20 篇论文 · 2018–2026*
图 27 · 帧插值 · 2018–2026*SVG

21 · 动作条件/世界模型

动作 / 世界模型。 以动作为条件的模型预测在给定动作与历史之后出现的观测或状态;策略则负责选择动作。World Models 通过以当前动作和记忆为条件的下一潜在状态概率分布,展示了这一 ML 表述。GameNGen 将历史帧和玩家动作转换为下一游戏帧。SonoWorld 是一篇有文献记录的超声预印本,利用电磁(EM)跟踪的自由手持扫描,以具有度量尺度的探头位姿为视频生成提供依据。其位姿控制评估,并不能证明每个针对新动作生成的响应都在物理上有效。验证应比较留出动作的响应、反向动作对照,以及累积的滚动生成漂移。重放记录的位姿或生成逼真的视频,并不能确立因果干预的有效性、安全的机器人控制或临床收益。时间线及示例依据以下来源 [281, 316, 317, 318, 319, 320, 321, 322, 22, 323, 324, 325, 282, 326, 327, 328, 329, 330, 331, 26]。
代表论文时间线20 篇论文
动作条件/世界模型 · 20 篇论文 · 2018–2026*
图 28 · 动作条件/世界模型 · 2018–2026*SVG

建模机制

机制规定目标与概率路径,而非任务或骨干网络。GAN、扩散和流匹配是图中展示的三个锚点,并不是穷尽式的机制分类。VAE、自回归模型和归一化流仍是不可或缺的基础[4, 332, 333, 334, 33, 34, 335]。下文的历史脉络解释机制层面发生了哪些变化,但不暗示更新的模型族就会自动保留更多信息。
ML–CV–医学影像对应关系22–24
建模机制
图 29 · 建模机制SVG

22 · GAN

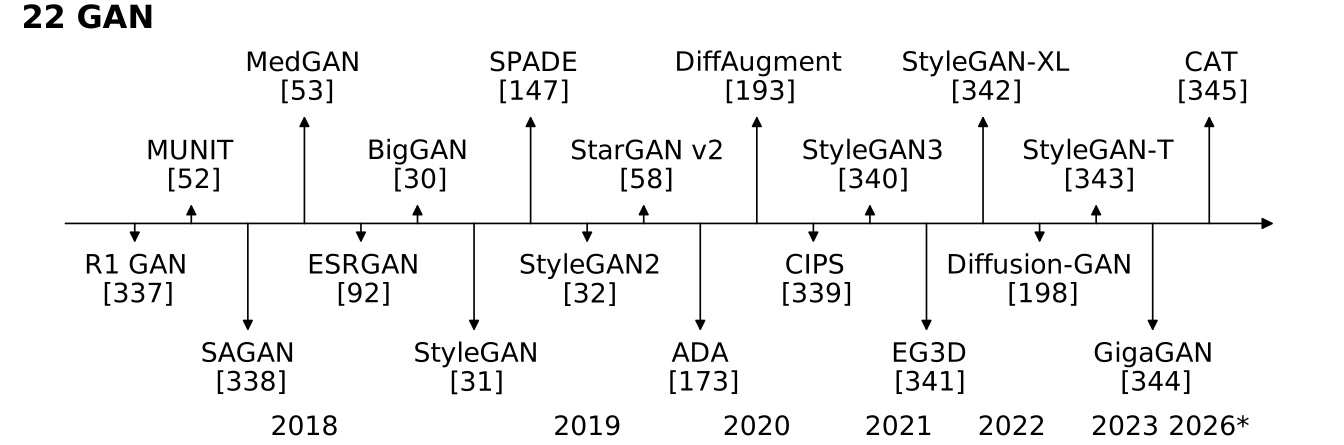
GAN。 GAN 的定义在于生成器与判别器之间的对抗学习,而非特定的网络架构或影像任务。ML 示例将随机潜在编码映射为样本,同时由判别器反馈提供学习得到的训练信号。StyleGAN 将这一原理用于图像合成,实现尺度特异的风格控制。MedGAN 将对抗损失、特征损失与风格损失用于 PET 到 CT 的转换,以进行衰减校正,而非直接用于 CT 诊断。这里,源扫描约束了期望的解剖内容,但这些损失并不能保证病灶或定量衰减值在转换后得以保留。评估应同时衡量分布覆盖度与逼真度,再检查配对解剖、定量误差和任务特异的阅片判断。判别器分数既不是诊断置信度,也不能证明所有临床重要模式均已得到表征。时间线及示例依据以下来源 [337, 52, 338, 53, 92, 30, 31, 147, 32, 58, 173, 193, 339, 340, 341, 342, 198, 343, 344, 345, 332]。
代表论文时间线20 篇论文
GAN · 20 篇论文 · 2018–2026*
图 30 · GAN · 2018–2026*SVG

23 · 扩散模型

扩散。 扩散模型学习如何逆转逐步施加的扰动,通常通过去噪或与噪声相关的得分估计来实现。ML 示例从噪声出发,反复应用学习到的逆过程。潜在扩散在压缩表征中执行这一过程,再将其解码为图像,文本或其他输入可作为可选条件。Medical Diffusion 报道了三维 MRI 与 CT 合成。其摘要报告了阅片者对外观、解剖正确性和切片一致性的评估;这一证据范围小于诊断等效性或隐私保护。验证应分别评估解剖结构、罕见异常、记忆化,以及独立临床任务上的性能。数值采样时间并非患者时间。确定性的概率流 ODE 也能从以得分训练的扩散模型中采样,因此,仅使用 ODE 并不能证明采用了流匹配训练。时间线及示例依据以下来源 [346, 33, 347, 34, 36, 97, 38, 7, 39, 40, 41, 348, 349, 19, 43, 44, 149, 46, 350, 351]。
代表论文时间线20 篇论文
扩散模型 · 20 篇论文 · 2018–2026*
图 31 · 扩散模型 · 2018–2026*SVG

24 · 流匹配

流匹配。 流匹配针对沿选定的源分布到数据分布概率路径所定义的目标,训练速度场。在 ML 层面,输入为中间样本和路径时间,输出为用于生成新样本的输运方向。整流流 Transformer 通过文本到图像合成提供了 CV 示例。Flow Matching for Medical Image Synthesis 报道了一种最优输运变体,可在类别或掩膜条件下生成 2D 和 3D 输出。这是一个训练坐标,并非任意可逆网络、光流估计器或 ODE 求解器的同义词。它可以与扩散共享概率路径和采样机制。验证应在明确的采样预算下检查输运准确性、条件遵循度和解剖结构。由摘要支持的这一医学应用,并不能确立临床收益、精确的解剖保留或普遍更快的生成速度。时间线及示例依据以下来源 [352, 353, 335, 354, 355, 356, 357, 358, 359, 360, 47, 361, 362, 363, 364, 365, 336, 366, 367, 368]。
代表论文时间线20 篇论文
流匹配 · 20 篇论文 · 2018–2026*
图 32 · 流匹配 · 2018–2026*SVG

约束与评价

要求关注哪些内容必须保持正确,以及有用的工作流程消耗哪些资源。保真度需要参照,效率需要预算,数据一致性需要具有噪声假设的前向模型。这些检验相互补充,不能彼此替代,而良好的平均值可能掩盖后果严重的失败。
ML–CV–医学影像对应关系25–27
约束与评价
图 33 · 约束与评价SVG

25 · 保真度

保真度。 保真度必须明确其参照:数据分布、输入条件、感知目标,或具有临床意义的特征。在 ML 层面,PRDC 中的密度与覆盖度指标区分样本保真度和分布覆盖度,而非将二者合并成单一分数。GenEval 通过检查生成对象的数量、颜色及空间关系是否符合文本提示,提供了 CV 示例;它是评估器,而非生成器。医学人类反馈框架利用病理学家判断、学习得到的奖励模型及扩散微调,提高临床合理性。逼真的纹理仍可能掩盖错误的细胞类型或遗漏的异常。因此,评估应在按患者隔离的测试条件下,纳入独立专家检查和任务特异检查。仅凭专家偏好或更好的通用图像分数,并不能确立诊断保真度或前瞻性效用。时间线及示例依据以下来源 [372, 373, 374, 375, 369, 376, 38, 377, 378, 379, 380, 381, 382, 371, 383, 370, 384, 385, 386, 387]。
代表论文时间线20 篇论文
保真度 · 20 篇论文 · 2018–2026*
图 34 · 保真度 · 2018–2026*SVG

26 · 效率

效率。 效率关注在何种输出质量下节省了哪种资源,而不只是减少了多少采样步骤。ML 比较应先固定数据、硬件和质量目标,再报告延迟、内存或训练成本。DPM-Solver 通过无需额外训练的专用扩散 ODE 求解器,展示了 CV 推理加速。MAISI-v2 报道了利用整流流和区域特异对比损失加速 3D 医学图像合成;它并非仅将 DPM-Solver 应用于医学扫描。这些机制也可同时占据其他坐标。测量完整工作流时,评估应纳入编码、解码、加载、后处理、质量控制、失败和重试。快速的采样内核或较少的网络求值次数,并不能证明端到端成本更低、病灶信息得到保留,或诊断性能具有非劣效性。时间线及示例依据以下来源 [347, 36, 7, 388, 389, 348, 349, 352, 390, 391, 392, 45, 393, 394, 395, 396, 397, 398, 366, 399, 27]。
代表论文时间线20 篇论文
效率 · 20 篇论文 · 2018–2026*
图 35 · 效率 · 2018–2026*SVG

27 · 测量一致性

测量一致性。 测量一致性通过指定的前向算子和噪声模型,检验重建结果与已采集数据的符合程度。ML 示例约束已观测分量,同时由生成先验补充尚未确定的分量。DDNM 通过在基于扩散的线性图像复原中修改零空间内容,展示了 CV 情形。基于得分的医学逆问题框架在测试时使用物理测量模型,由测量数据重建 CT 或 MRI。DPS 进一步说明,含噪观测需要考虑噪声的目标函数,而非不加区分地投影到精确拟合结果。验证应根据所声明的噪声统计特性检查残差,并将临床相关结构与独立参考进行比较。较小的残差并不能确定算子零空间中的解剖结构:不同图像可能产生完全相同的观测。无论是测量拟合,还是一个合理的后验样本,单独都不能确立未观测部分的真值或经过校准的不确定性。时间线及示例依据以下来源 [400, 114, 115, 20, 100, 17, 116, 19, 391, 117, 401, 402, 403, 404, 121, 122, 405, 124, 406, 407]。
代表论文时间线20 篇论文
测量一致性 · 20 篇论文 · 2018–2026*
图 36 · 测量一致性 · 2018–2026*SVG

跨维度趋势与证据综合

04 / 07

哪些内容正在变化,曲线不能证明什么

机制变化的速度快于底层问题的变化。图1显示,在当前年份的末端之前,GAN 词汇下降、扩散词汇上升,但在任一机制下,合成、重建和控制仍是不同的操作。在完整查询框架的二元提及统计中,GAN 从 2018 年的 176/428(41.12%)降至 2025 年的 226/6,219(3.63%);扩散从 0/428 升至 2,353/6,219(37.84%)。2025 年有 231/6,219 条记录(3.71%)出现流匹配。这些变化描述的是该查询中的语言使用,而非对准确性、成本或临床效用的受控比较。读者选择重建问题时,应先确定其信息与误差约束,再选择机制,而不应颠倒顺序。
2026 年更突出与动作相关的语言,但这不是完整年度的增长检验。在 7,019 条年初至今的记录中,时序生成匹配 1,867 条(26.60%),动作条件匹配 2,086 条(29.72%),扩散匹配 1,544 条(22.00%),流匹配 401 条(5.71%)。动作条件的概念平均 TF–IDF 为 0.1803,2025 年为 0.0739;扩散为 0.0600,2025 年为 0.1068。查询构成、索引情况和写作选择都可能改变这些量。尤其是,动作概念还包括未匹配时序生成的工作,而固定的 102 概念归一化使各面板的幅值相互关联。更高的动作曲线并不能证明模型学到了有用的干预;这需要将动作条件检验与重放及其他强对照进行比较。
稳健的方向比精确的领域占比更站得住脚。历史出现比例的敏感性分析显示,2018–2025 年 GAN 的变化介于 \(-50.17\) 与 \(-20.47\) 个百分点之间,扩散介于 \(+12.08\) 与 \(+58.30\) 之间,流匹配介于 \(+1.51\) 与 \(+5.71\) 之间。这些是不同分析设定下的范围,并非置信区间。在这些经过检验的定义下,变化方向保持一致,幅度却不一致。对 96 条记录的相关性审计解释了为何将某一个过滤后的分母视为全部文献会产生误导。因此,本综述用计数来定位需要核查证据的问题,而不是给研究主题的科学价值排序。

维度组合比孤立关键词更重要

跨坐标匹配显示哪些组合值得进一步阅读。我们预先选定了五对概念,覆盖机制、条件、数据范式、组织、操作和要求,随后在全部 25,056 篇摘要上重新应用冻结规则。全部 918 个年度概念计数均精确复现。表2以联合匹配数除以锚点匹配数,因此其分母不同于图谱,且每行回答一个特定的条件问题。这是对书面表述的诊断性视图,而非相应组件已被共同实现的证据。

表 2 · 跨维度词汇共现

锚点 / 配对项 2025 2026*
扩散 / 文本条件 1243/2353 (52.8%) 753/1544 (48.8%)
时序生成 / 动作 139/1519 (9.2%) 369/1867 (19.8%)
多模态 / 文本条件 520/1089 (47.8%) 422/1040 (40.6%)
少样本 / 文本条件 35/77 (45.5%) 27/68 (39.7%)
测量逆问题 / 数据一致性 8/117 (6.8%) 10/123 (8.1%)
动作相关的变化并不只是时序论文增多。2025 年,动作术语出现在 139/1,519 条时序生成匹配记录中(9.2%);2026 年截至当前日期则为 369/1,867(19.8%)。这支持进一步考察从生成序列到预测所提供动作之结果的转变。它不能确定测量了哪些动作、是否观测到隐状态,或策略能否迁移。相比之下,在两个快照中,文本条件术语均出现在约一半的扩散匹配记录中(52.8% 和 48.8%):扩散与文生图不应被视为同义词。对多模态和少样本各行也需同样谨慎;它们在文本中的共同提及不能证明任意模态到任意模态的生成能力,也不能证明预训练预算可比。
稀疏词汇是检索警示,而非领域空白。2025 年,明确的数据一致性短语仅与 8/117 条测量反演匹配记录共同出现,2026 年为 10/123。这不能支持“大多数重建方法忽视测量”的说法:似然、前向算子、投影以及领域专用术语可能不使用这些词,却表达相同思想。同样,较低的联合生成或插值曲线也不能证明相应应用尚未被研究。候选空白必须经受同义词扩展、直接近邻阅读,以及检查所提改进是否已在另一坐标下得到表达。

从已实现能力到有证据支持的用途

子任务的成熟度不存在一个统一的标量。实现、外部图像评估、临床阅片者一致性、工作流程可行性和患者结局回答的是不同问题。表3将这些区别落实到具名研究上。它记录选定研究实际检验了什么,而非将这些证据赋予所有共享同一任务标签的论文。临床非扩散 MRI 对照可以证明某种特定加速工作流程能够接受检验,却不能验证新的扩散采样器。反过来,一种近期的生成方法也不必先部署到临床,才能提供有用且边界明确的技术结果。
这些选定来源涵盖不同操作和验证层次。它们并非全部 27 个子项的代表性样本,其局限应始终对应所指名的工作流,而不应泛化到整个机制。

表 3 · 具名研究的证据与边界

来源 / 用途 评估内容 不可据此得出的结论
MAISI [9] 条件体积生成;外部 autoPET 图像分布及下游分割测试。 诊断收益、罕见病理覆盖度或隐私保证。
基于得分的医学逆问题 [20] 使用模拟投影或单线圈测量的 CT/MRI 逆问题任务。 前瞻性扫描仪验证或独立阅片者验证。
加速膝关节 MRI [408] 纳入 170 名参与者、六名阅片者的前瞻性可互换性研究。 手术真值、跨厂商性能或新扩散方法的验证。
仅 MR 脑部放疗 [12] 在 20/21 例中完成工作流,并针对伪影采用回退方案。 合成 CT 的普遍可靠性或患者结局改善。
UV-PARS 虚拟组织学 [409] 由三名病理学家开展诊断一致性和盲法质量比较。 手术切缘或患者结局方面的收益。
CAN-FLOW [28] 以元数据为条件的静态健康解剖;亚组及尾部比较。 疾病状态下的动力学或器械试验终点。
Cardiac Mesh Flow [25] 动态网格基准测试和静态心脏周期性对照。 独立局部运动真值或患者特异生理。
VICTRE [410] 基于程序化建模 / 物理模型的虚拟乳腺摄影比较;2,986 名虚拟患者。 学习生成队列的普遍有效性、恶性病变诊断或死亡率预测。
SonoWorld [26] 基于位姿的超声;42 名受试者,33/9 划分;动作选择 / 重放测试。 经独立验证的真实机器人临床策略迁移,或在接触力变化下仍成立的动力学。
在医学附加更多约束之前,可以先从机器学习和 CV 中归纳出三项普遍优先事项。第一,检验组合泛化:能否将各自有用的条件组合起来,而不破坏某个不变量?第二,比较包括预训练资源获取、目标样例及逐样本推理在内的总资源,而不是将冻结模型或小型适配器一概称为高效。第三,选择一个能够与生成器得出不同结论的评估器。这些是综合分析得出的优先事项,而非已验证的新颖研究空白。JointNet 已经耦合视觉输出,MedSegFactory 已经生成医学图像—掩膜对,CHeart 和 Cardiac Mesh Flow 也已经建模动态解剖结构[205, 206, 24, 25]。因此,仅仅拼接输出或加入时间维度并不足够。
独立真值是多个表面空白背后真正稀缺的资源。图像及其生成掩膜可能共享同一条错误边界;平滑周期序列可能是静止的;大型虚拟队列可能遗漏目标疾病的尾部情况。所核查的 MedSegFactory 设计是二维的,而经过处理的分割或配准参照不会因为稠密就成为独立的运动真值[206, 25, 245]。接下来有价值的问题是:当前评估器会接受哪种错误输出?医学应用通过将误差联系到测量、诊断、治疗量或经过验证的试验终点,使这一问题更加明确。

医学需求与验证

05 / 07
医学任务应从误差可能改变的决策出发。相关链条依次是目标人群、采集、生成输出、解读、行动和终点。只有保留了所需的联系,逼真的图像才有用。图37展示三个选定的医学工作流程,并非完整分类体系,也不是通用的成熟度阶梯。它与对应关系图互补:对应图解释含义,而本图在选定医学用途后定位验证义务。
选定医学场景的验证路径
图 37 · 选定医学场景的验证路径SVG

采集与重建:保留影响决策的信息

只有重要误差仍处于可接受范围内,更快的采集才有价值。重建研究需要原始数据划分、现实的算子变化、强确定性与生成式对照,以及预先规定的病灶或定量终点。一项前瞻性膝关节 MRI 研究采用 170 名参与者和六名阅片者来检验可互换性,但缺乏手术真值,且仅使用单一厂商设备[408]。它是非扩散对照,展示的是评估设计,而不是验证了更新的先验。符合数据一致性的样本在观测不足的结构上仍可能不同;幻觉相关工作已经明确提出这一问题[89, 18]。有用的不确定性输出应识别需要再次测量或启用后备方案的病例,并将采集与审核负担计入其中。
当下游使用某个定量结果时,转换便具有实际后果。在仅使用 MR 的放射治疗中,合成 CT 支持剂量计算和定位,而不只是提供类似 CT 的外观。所核查的一项脑部放疗(RT)工作流程完成了 20/21 个病例,并暴露出与止血材料相关、因伪影而启用后备方案的情况[12]。其发现只适用于该工作流程;另行开展的基于图谱的合成 CT 质量保证并不是所有学习式生成器的通用合格证明[411]。SynthRAD 将图像、几何和剂量标准分开[50]。这使一个实际研究问题变得明确:在会造成失败的扫描仪、病理和植入物条件下,方法能否保留与剂量相关的量,以及能否识别自己未能保留的情况?

诊断性转换:保留标签背后的结构

虚拟染色必须保留诊断证据,而不只是染色风格。配准、组织制备及参照质量都会影响配对比较。UV-PARS 报告了诊断一致性,以及由三名病理医师开展的盲法图像质量比较,但并未报告手术切缘或患者结局的改善[409]。近期关于使用情境的讨论与验证设计有关,但仅核查摘要的近邻文献不能支撑详细的实证主张[412]。有用的研究应将特定征象的遗漏、额外引入的结构和无法阅片的病例分开,检验组织与中心变化,并保留病理医师审核。将这些误差平均成一个漂亮的感知分数,会抹去进行这种转换的初衷。

虚拟试验:同时验证人群与仿真器

更多虚拟患者只能在所假定的模型内部降低抽样误差。VICTRE 通过程序化乳房生成、成像物理及观察者,在 2,986 名虚拟患者上比较乳腺 X 线成像系统,并与人体试验进行了比较[410]。它并非学习式生成 AI 的发明,其所展示的检测任务也不能验证恶性诊断或死亡率。病灶、运动、视角及目标人群的有限覆盖限制了外推。CAN-FLOW 的条件解剖结构及尾部分析是相关组成要素,但所核查的健康静态数据不能证明其能够构建患病动态试验队列[28]。因此,学习式生成器除逼真性之外,还必须证明对目标人群的覆盖及终点敏感性。扩大队列不能消除解剖、物理、观察者或抽样假设中的偏差。
患者特异性仿真所需的不只是一个具有患者形状的对象。虚拟心脏消融研究已有回顾性和小规模前瞻性证据,但在工作流程的某些环节使用了平均电生理参数[413]。仅凭动态几何无法辨识个体的材料、传导或治疗响应参数。同样,姿态条件超声生成也无法确定接触力、组织变形或扫描仪设置的影响[26, 127]。合适的中间目标包括独立核查的局部运动、经过测量的动作—观测关系,以及经过验证的终点变化。关于治疗或策略有效性的更强主张,应等待能够使其可辨识的额外测量。
验证指南必须与模型所承担的角色匹配。FDA 可信度指南关注其规定的物理/机理范围内的计算建模与仿真,并非针对所有生成式 AI 的普遍审批指南[414]。DECIDE-AI 面向早期真实临床环境中的决策支持评估,而非通用的离线合成[415]。二者都促使研究明确报告使用情境、风险和工作流程,但符合检查清单并不能证明模型质量。研究应说明支持的是哪项决策、可容忍什么误差、哪种独立参照能够检测这种误差,以及系统拒绝处理或发生失败时如何应对。

研究机会与局限

06 / 07

选择缺失的证据,而不是追逐热门名称

有潜力的课题将真实瓶颈与新近可检验的能力相联系。热门关键词可能掩盖重要但尚未解决的终点;鲜被提及的组合则可能不可辨识、没有必要,或已用其他词汇为人所知。图38将文献层面的新颖性与检验有用改进所需的证据区分开来。在将某事称为空白之前,应区分缺少实现、缺少独立验证、人群缺乏支持、没有需求和参照不可获取。这些情况会导向不同的项目。以下四个案例明确属于面向医学的假设,并非生成式 AI 的穷尽式议程,不是对全部 27 个子项的排名,也不是对论文录用的预测。
从文献缺口到有判别力的研究试验
图 38 · 从文献缺口到有判别力的研究试验SVG
依据实际可获得的验证资源进行选择。原始测量和可靠决策适合支持选择性重建研究;独立局部运动适合支持耦合动力学;目标疾病覆盖和经终点验证的仿真器适合支持队列研究;安全跟踪的动作适合支持观测/控制研究。缺少这些资源时,范围更窄的基准或评估器可能比另一个大型生成器更有用。通用机器学习贡献仍需可迁移能力检验;特定用途的工程改进与临床工作流程改进属于不同贡献,彼此都不应继承对方的证据。

四个有边界的医学研究假设

O1:具有决策校准后备机制的选择性重建或转换。DPS、幻觉指标、情境特定评估和主动测量选择已经存在[19, 18, 412, 109]。Steerable Conditional Diffusion 已能根据测量调整先验;DynamicDPS 评估低场 MRI 的组织体积误差;HalluGen 提供可控幻觉及检测器基准[416, 417, 418]。因此,通用的分布外(OOD)适配器或幻觉检测器并不是这里的空白。更窄的假设是:接受、拒绝或额外采集能以可接受的总负担降低预先规定的决策损失。对于接受变量 \(a\) 和决策损失 \(L\),应报告
\[\mathrm{coverage}=\mathbb{E}[a],\quad \mathrm{risk}=\frac{\mathbb{E}[aL]}{\mathbb{E}[a]},\quad \mathrm{burden}=\mathbb{E}[\mathrm{time}+\lambda\,\mathrm{fallback\ cost}],\]
其中接受率必须非零,使用留出数据进行校准,明确单位,并为权衡参数提供合理依据。在检验困难病理与采集变化之前,先冻结患者划分与决策界限。如果仅相似度改善、危险误差仍未被识别,或后备方案抵消了收益,就应停止。所主张的增量是在定义明确的变化下提高决策可靠性,而不只是可视化不确定性。
O2:以独立局部真值为基础的解剖结构—观测联合生成。JointNet、MedSegFactory 和 AortaDiff 已经耦合输出;CHeart 和 Cardiac Mesh Flow 已经建模动态解剖结构[205, 206, 49, 24, 25]。MIVAE 也已经通过跨域重建和外部特征检验学习心脏图像/网格表示[245]。因此,多一个分支、网格或时间维度并不足够。应检验耦合是否改善了在生成标注流程之外测量的局部量。比较串行生成、联合图像—掩膜模型和非生成式测量基线;只有终点需要几何时才使用几何。静态输出、条件不匹配,以及总体体积匹配但局部错误的解剖结构,都应能够暴露弱评估器的问题。如果现有参照无法区分这些对照,应先构建验证数据。如果图像—掩膜输出已经足够,强行引入网格只会增加表示成本,却没有已证明的收益。
O3:虚拟队列面向目标人群的尾部风险可信度。条件解剖结构与尾部、基于图的队列以及虚拟成像终点,都已有直接近邻研究[28, 419, 420, 410]。分层可信度研究已经区分队列、患者、器械和临床医师子模型[421];考虑人群的验证并非本议程的发明。更窄的目标是在存在人群与参数不确定性时,保留外部终点风险分布。首先定义疾病分层及其覆盖,然后通过同一个经过适当验证的仿真器,比较重采样、PCA、程序化队列和学习式队列。评估 \(R_T=\mathbb{E}_{z\sim P_T}[L(z)]\),分别纳入尾部误差、人群不确定性和蒙特卡洛误差。加权不能创造原本缺失的疾病覆盖,更多样本也不能消除仿真器偏差。如果目标人群或终点有效性未知,应停止作出可信试验的主张;边界明确的解剖结构生成结果仍可能有用。
O4:超越已记录轨迹、在动作层面有效的观测模型。EchoWorld 和 SonoWorld 已是直接的超声近邻研究[127, 26];这并非提出首个医学世界模型。应转而检验:在独立跟踪的留出运动下,生成观测能否保留动作优劣排序,并改善重放之外的控制。先在安全体模上开展,比较重放、最近邻检索、插值及合适的几何基线。改变接触力、变形和扫描仪设置,分别评估观测保真度、动作选择和闭环成功率。声称能够迁移到真实采集,需要适当且经过批准的平台及独立测量。如果增益仅归结为平滑性、重放,或策略利用仿真器伪影,就应停止。预测性自回归并不等于治疗效果辨识。
表 4 将四个案例转化为项目启动检验。它有意作为资源与终点指南,而非另一套任务分类体系;每个案例均组合了前述多个坐标。

表 4 · 四个医学研究机会的进入条件

案例 必需资源 决定性比较 何时停止或收窄
O1 原始测量或对齐真值;明确的决策。 与强确定性方法和生成方法比较风险–覆盖率–负担。 拒绝机制未经校准,或回退方案抵消了收益。
O2 独立的局部几何 / 运动参考。 联合生成与串行生成比较;设置静态及局部错误对照。 共享标签无法发现共同错误。
O3 有数据支持的目标疾病人群;经验证的终点模拟器。 与重采样、PCA、程序化及学习生成队列比较尾部风险。 缺乏人群支持或终点有效性。
O4 安全平台;独立跟踪的留出动作。 与重放、检索和插值比较真实动作成功情况。 收益仅限重放,或来自对伪影的利用。

局限与下一步决策

本综述不能认证某领域为空白、某课题最佳或已具备临床应用条件。查询会遗漏使用不同名称的研究,也会纳入仅在背景中提及相关概念的记录;历史审计与敏感性检验并未验证所有标签或 2026 年扩展。目的性选择偏向可获取且显著的工作。单一 AI 辅助提取缺少独立专家裁定,而摘要或经索引访问的证据弱于本地核查的原文段落。时间线里程碑不是引用排名,四项机会则是未经检验的假设。候选项目必须在设计冻结时更新最近邻检索,尤其应关注近期预印本。本文不能据此作出全领域缺失、全球首创、监管评估或录用概率的主张。
下一项有用产出是一个小规模但有判别力的先导验证。在训练模型之前,先用一页纸写清目标人群、可用输入、必要不变量、独立参照、对照方法和停止条件。先验证参照能够排除看似合理的错误对照,再检验能够实现所提增量的最小系统。只有通过这一关才扩大规模。阴性先导结果可以支持缩小主张范围、改进评估器或调整资源分配。相反,在看到结果后放宽终点,会消除这项研究之所以重要的理由。

结论

07 / 07
八个坐标与 27 项历史脉络将生成所执行的操作与其条件、资源、表示及机制区分开来。这使复用与分歧都更容易理解:更换模型族不一定改变任务,而同一操作在 CV 与医学中可能需要截然不同的真值。描述性语料显示了向动作相关语言与较新机制的转变;它本身不能替人选择研究课题。更有力的依据是一个具体且尚未满足的终点,配有独立真值,以及能够满足相同需求的对照方法。对于医学应用,选择性决策可靠性、以独立证据为基础的动力学、目标人群覆盖和动作层面有效的观测,都是有用且边界明确的检验。下一项贡献应是能够改变重要结果的最小已验证能力,而不是规模最大的生成输出集合。

透明性与可复现性

这是一份由 Codex 辅助完成的研究草稿,而非经独立审定的临床综述。检索、段落提取、编码、综合和写作均使用了当前 Codex 系统;投稿或临床解读前需要专家核验。本文不声称开展了新的患者实验、训练,或取得了新的伦理批准或前瞻性注册。归档材料包含来源标识、查验位置、编码规则、分析表、可编辑图源和编译说明。不重新分发第三方全文 PDF。期刊排名和热度不是证据等级。第 6.3 节所述局限适用于全文。

论文原题: Generative Models for Vision and Medical Imaging: Eight Coordinates, 27 Subtasks, and an Evidence-Based Research Agenda

论文文献库

383 / 540

383 篇论文

参考文献421
  1. Diffusion Models in Vision: A SurveyFlorinel-Alin Croitoru, Vlad Hondru, Radu Tudor Ionescu, Mubarak Shah · 2022
  2. Generative Artificial Intelligence in Medical Imaging: Foundations, Progress, and Clinical TranslationXuanru Zhou, Cheng Li, Shuqiang Wang, Ye Li, Tao Tan, Hairong Zheng, Shanshan Wang · 2025
  3. Vision Language Models: A Survey of 26K PapersFengming Lin · 2025
  4. Auto-Encoding Variational BayesDiederik P Kingma, Max Welling · 2013
  5. Compressed Sensing using Generative ModelsAshish Bora, Ajil Jalal, Eric Price, Alexandros G. Dimakis · 2017
  6. Few-shot Image Generation via Cross-domain CorrespondenceUtkarsh Ojha, Yijun Li, Jingwan Lu, Alexei A. Efros, Yong Jae Lee, Eli Shechtman, Richard Zhang · 2021
  7. High-Resolution Image Synthesis with Latent Diffusion ModelsRobin Rombach, Andreas Blattmann, Dominik Lorenz, Patrick Esser, Björn Ommer · 2021
  8. Text2Tex: Text-driven Texture Synthesis via Diffusion ModelsDave Zhenyu Chen, Yawar Siddiqui, Hsin-Ying Lee, Sergey Tulyakov, Matthias Nießner · 2023
  9. MAISI: Medical AI for Synthetic ImagingPengfei Guo, Can Zhao, Dong Yang, Ziyue Xu, Vishwesh Nath, Yucheng Tang, Benjamin Simon, Mason Belue, Stephanie Harmon, Baris Turkbey, Daguang Xu · 2024
  10. Image-to-Image Translation with Conditional Adversarial NetworksPhillip Isola, Jun-Yan Zhu, Tinghui Zhou, Alexei A. Efros · 2016
  11. Unpaired Image-to-Image Translation using Cycle-Consistent Adversarial NetworksJun-Yan Zhu, Taesung Park, Phillip Isola, Alexei A. Efros · 2017
  12. Prospective Clinical Feasibility Study for MRI-Only Brain RadiotherapyLerner, Minna, Medin, Joakim, Jamtheim Gustafsson, Christian, Alkner, Sara, Olsson, Lars E · 2022
  13. Deep learning-based virtual histology staining using auto-fluorescence of label-free tissueYair Rivenson, Hongda Wang, Zhensong Wei, Yibo Zhang, Harun Gunaydin, Aydogan Ozcan · 2018
  14. InstructPix2Pix: Learning to Follow Image Editing InstructionsTim Brooks, Aleksander Holynski, Alexei A. Efros · 2022
  15. Probing the limits and capabilities of diffusion models for the anatomic editing of digital twinsKarim Kadry, Shreya Gupta, Farhad R. Nezami, Elazer R. Edelman · 2024
  16. Palette: Image-to-Image Diffusion ModelsChitwan Saharia, William Chan, Huiwen Chang, Chris A. Lee, Jonathan Ho, Tim Salimans, David J. Fleet, Mohammad Norouzi · 2021
  17. Denoising Diffusion Restoration ModelsBahjat Kawar, Michael Elad, Stefano Ermon, Jiaming Song · 2022
  18. Hallucination Index: An Image Quality Metric for Generative Reconstruction ModelsMatthew Tivnan, Siyeop Yoon, Zhennong Chen, Xiang Li, Dufan Wu, Quanzheng Li · 2024
  19. Diffusion Posterior Sampling for General Noisy Inverse ProblemsHyungjin Chung, Jeongsol Kim, Michael T. Mccann, Marc L. Klasky, Jong Chul Ye · 2022
  20. Solving Inverse Problems in Medical Imaging with Score-Based Generative ModelsYang Song, Liyue Shen, Lei Xing, Stefano Ermon · 2021
  21. Video Diffusion ModelsJonathan Ho, Tim Salimans, Alexey Gritsenko, William Chan, Mohammad Norouzi, David J. Fleet · 2022
  22. Genie: Generative Interactive EnvironmentsJake Bruce, Michael Dennis, Ashley Edwards, Jack Parker-Holder, Yuge Shi, Edward Hughes, Matthew Lai, Aditi Mavalankar, Richie Steigerwald, Chris Apps, Yusuf Aytar, Sarah Bechtle, Feryal Behbahani, Stephanie Chan, Nicolas Heess, Lucy Gonzalez, Simon Osindero, Sherjil Ozair, Scott Reed, Jingwei Zhang, Konrad Zolna, Jeff Clune, Nando de Freitas, Satinder Singh, Tim Rocktäschel · 2024
  23. 4D-fy: Text-to-4D Generation Using Hybrid Score Distillation SamplingSherwin Bahmani, Ivan Skorokhodov, Victor Rong, Gordon Wetzstein, Leonidas Guibas, Peter Wonka, Sergey Tulyakov, Jeong Joon Park, Andrea Tagliasacchi, David B. Lindell · 2023
  24. CHeart: A Conditional Spatio-Temporal Generative Model for Cardiac AnatomyMengyun Qiao, Shuo Wang, Huaqi Qiu, Antonio de Marvao, Declan P. O'Regan, Daniel Rueckert, Wenjia Bai · 2023
  25. Cardiac Mesh Flow: One-Step Generation of 3D+t Cardiac Four-Chamber Meshes via Flow MatchingQiang Ma, Qingjie Meng, Mengyun Qiao, Paul M. Matthews, Declan P. O'Regan, Wenjia Bai · 2026
  26. SonoWorld: Towards Interactive Pose-Controllable Ultrasound World ModelsZefan Yang, Zheyuan Zhang, Boris Maihe, Yikang Liu, Hang Yu, Ankush Mukherjee, Xiao Chen, Pingkun Yan, Terrence Chen, Shanhui Sun · 2026
  27. MAISI-v2: Accelerated 3D High-Resolution Medical Image Synthesis with Rectified Flow and Region-specific Contrastive LossCan Zhao, Pengfei Guo, Dong Yang, Yucheng Tang, Yufan He, Benjamin Simon, Mason Belue, Stephanie Harmon, Baris Turkbey, Daguang Xu · 2025
  28. Flow-based conditional cardiac anatomy generation for virtual cohortsKonstantinos Kevopoulos, Beatrice Moscoloni, Benjamin Alheit, Cameron Beeche, Julio A. Chirinos, Alexander Heinlein, Mathias Peirlinck · 2026
  29. SDF4CHD: Generative Modeling of Cardiac Anatomies with Congenital Heart DefectsFanwei Kong, Sascha Stocker, Perry S. Choi, Michael Ma, Daniel B. Ennis, Alison Marsden · 2023
  30. Large Scale GAN Training for High Fidelity Natural Image SynthesisAndrew Brock, Jeff Donahue, Karen Simonyan · 2018
  31. A Style-Based Generator Architecture for Generative Adversarial NetworksTero Karras, Samuli Laine, Timo Aila · 2018
  32. Analyzing and Improving the Image Quality of StyleGANTero Karras, Samuli Laine, Miika Aittala, Janne Hellsten, Jaakko Lehtinen, Timo Aila · 2019
  33. Denoising Diffusion Probabilistic ModelsJonathan Ho, Ajay Jain, Pieter Abbeel · 2020
  34. Score-Based Generative Modeling through Stochastic Differential EquationsYang Song, Jascha Sohl-Dickstein, Diederik P. Kingma, Abhishek Kumar, Stefano Ermon, Ben Poole · 2020
  35. Taming Transformers for High-Resolution Image SynthesisPatrick Esser, Robin Rombach, Björn Ommer · 2020
  36. Improved Denoising Diffusion Probabilistic ModelsAlex Nichol, Prafulla Dhariwal · 2021
  37. Zero-Shot Text-to-Image GenerationAditya Ramesh, Mikhail Pavlov, Gabriel Goh, Scott Gray, Chelsea Voss, Alec Radford, Mark Chen, Ilya Sutskever · 2021
  38. Diffusion Models Beat GANs on Image SynthesisPrafulla Dhariwal, Alex Nichol · 2021
  39. GLIDE: Towards Photorealistic Image Generation and Editing with Text-Guided Diffusion ModelsAlex Nichol, Prafulla Dhariwal, Aditya Ramesh, Pranav Shyam, Pamela Mishkin, Bob McGrew, Ilya Sutskever, Mark Chen · 2021
  40. Hierarchical Text-Conditional Image Generation with CLIP LatentsAditya Ramesh, Prafulla Dhariwal, Alex Nichol, Casey Chu, Mark Chen · 2022
  41. Photorealistic Text-to-Image Diffusion Models with Deep Language UnderstandingChitwan Saharia, William Chan, Saurabh Saxena, Lala Li, Jay Whang, Emily Denton, Seyed Kamyar Seyed Ghasemipour, Burcu Karagol Ayan, S. Sara Mahdavi, Rapha Gontijo Lopes, Tim Salimans, Jonathan Ho, David J Fleet, Mohammad Norouzi · 2022
  42. Scaling Autoregressive Models for Content-Rich Text-to-Image GenerationJiahui Yu, Yuanzhong Xu, Jing Yu Koh, Thang Luong, Gunjan Baid, Zirui Wang, Vijay Vasudevan, Alexander Ku, Yinfei Yang, Burcu Karagol Ayan, Ben Hutchinson, Wei Han, Zarana Parekh, Xin Li, Han Zhang, Jason Baldridge, Yonghui Wu · 2022
  43. Medical Diffusion: Denoising Diffusion Probabilistic Models for 3D Medical Image GenerationFiras Khader, Gustav Mueller-Franzes, Soroosh Tayebi Arasteh, Tianyu Han, Christoph Haarburger, Maximilian Schulze-Hagen, Philipp Schad, Sandy Engelhardt, Bettina Baessler, Sebastian Foersch, Johannes Stegmaier, Christiane Kuhl, Sven Nebelung, Jakob Nikolas Kather, Daniel Truhn · 2022
  44. Scalable Diffusion Models with TransformersWilliam Peebles, Saining Xie · 2022
  45. Consistency ModelsYang Song, Prafulla Dhariwal, Mark Chen, Ilya Sutskever · 2023
  46. SDXL: Improving Latent Diffusion Models for High-Resolution Image SynthesisDustin Podell, Zion English, Kyle Lacey, Andreas Blattmann, Tim Dockhorn, Jonas Müller, Joe Penna, Robin Rombach · 2023
  47. Scaling Rectified Flow Transformers for High-Resolution Image SynthesisPatrick Esser, Sumith Kulal, Andreas Blattmann, Rahim Entezari, Jonas Müller, Harry Saini, Yam Levi, Dominik Lorenz, Axel Sauer, Frederic Boesel, Dustin Podell, Tim Dockhorn, Zion English, Kyle Lacey, Alex Goodwin, Yannik Marek, Robin Rombach · 2024
  48. Qwen-Image-2.0 Technical ReportBing Zhao, Chenfei Wu, Deqing Li, Hao Meng, Jiahao Li, Jie Zhang, Jingren Zhou, Junyang Lin, Kaiyuan Gao, Kuan Cao, Kun Yan, Liang Peng, Lihan Jiang, Niantong Li, Ningyuan Tang, Shengming Yin, Tianhe Wu, Xiao Xu, Xiaoyue Chen, Xihua Wang, Yan Shu, Yanran Zhang, Yi Wang, Yilei Chen, Ying Ba, Yixian Xu, Yujia Wu, Yuxiang Chen, Zecheng Tang, Zekai Zhang, Zhendong Wang, Zihao Liu, Zikai Zhou, An Yang, Chen Cheng, Chenxu Lv, Dayiheng Liu, Fan Zhou, Hantian Xiong, Hongzhu Shi, Hu Wei, Huihong Zhao, Ivy Liu, Jianwei Zhang, Jiawei Zhang, Kai Chen, Kang He, Levon Xue, Lin Qu, Linhan Tang, Luwen Feng, Minggang Wu, Minmin Sun, Na Ni, Rui Men, Shuai Bai, Sishou Zheng, Tao Lan, Tianqi Zhang, Tingkun Wen, Wei Wang, Weixu Qiao, Weiyi Lu, Wenmeng Zhou, Xiaodong Deng, Xiaoxiao Xu, Xinlei Fang, Xionghui Chen, Yanan Wang, Yang Fan, Yichang Zhang, Yixuan Xu, Yu Wu, Zhiyuan Ma, Zhizhi Cai · 2026
  49. AortaDiff: A Unified Multitask Diffusion Framework For Contrast-Free AAA ImagingYuxuan Ou, Ning Bi, Jiazhen Pan, Jiancheng Yang, Boliang Yu, Usama Zidan, Regent Lee, Vicente Grau · 2025
  50. Generating synthetic computed tomography for radiotherapy: SynthRAD2025 challenge reportViktor Rogowski, Maarten L. Terpstra, Niklas Wahl, Florian Kamp, Erik van der Bijl, Arthur Jr. Galapon, Christopher Kurz, Bowen Xin, Zhengxiang Sun, Hollie Min, Gregg Belous, Jason Dowling, Yan Xia, Siyuan Mei, Fuxin Fan, Arthur Longuefosse, Javier Sequeiro Gonzalez, Miguel Diaz Benito, Alvaro Garcia Martin, Fabien Baldacci, Valentin Boussot, Cédric Hémon, Jean-Claude Nunes, Jean-Louis Dillenseger, Zhiyuan Zhang, Jinghua Cai, Han Bing, Tan Zuopeng, Ricardo Brioso, Daniele Loiacono, Guillaume Landry, Adrian Thummerer, Matteo Maspero · 2026
  51. Image Synthesis in Multi-Contrast MRI with Conditional Generative Adversarial NetworksSalman Ul Hassan Dar, Mahmut Yurt, Levent Karacan, Aykut Erdem, Erkut Erdem, Tolga Çukur · 2018
  52. Multimodal Unsupervised Image-to-Image TranslationXun Huang, Ming-Yu Liu, Serge Belongie, Jan Kautz · 2018
  53. MedGAN: Medical Image Translation using GANsKarim Armanious, Chenming Jiang, Marc Fischer, Thomas Küstner, Konstantin Nikolaou, Sergios Gatidis, Bin Yang · 2018
  54. Diverse Image-to-Image Translation via Disentangled RepresentationsHsin-Ying Lee, Hung-Yu Tseng, Jia-Bin Huang, Maneesh Kumar Singh, Ming-Hsuan Yang · 2018
  55. Unpaired Brain MR-to-CT Synthesis using a Structure-Constrained CycleGANHeran Yang, Jian Sun, Aaron Carass, Can Zhao, Junghoon Lee, Zongben Xu, Jerry Prince · 2018
  56. Few-Shot Unsupervised Image-to-Image TranslationMing-Yu Liu, Xun Huang, Arun Mallya, Tero Karras, Timo Aila, Jaakko Lehtinen, Jan Kautz · 2019
  57. U-GAT-IT: Unsupervised Generative Attentional Networks with Adaptive Layer-Instance Normalization for Image-to-Image TranslationJunho Kim, Minjae Kim, Hyeonwoo Kang, Kwanghee Lee · 2019
  58. StarGAN v2: Diverse Image Synthesis for Multiple DomainsYunjey Choi, Youngjung Uh, Jaejun Yoo, Jung-Woo Ha · 2019
  59. Reusing Discriminators for Encoding: Towards Unsupervised Image-to-Image TranslationRunfa Chen, Wenbing Huang, Binghui Huang, Fuchun Sun, Bin Fang · 2020
  60. Rethinking the Truly Unsupervised Image-to-Image TranslationKyungjune Baek, Yunjey Choi, Youngjung Uh, Jaejun Yoo, Hyunjung Shim · 2020
  61. Contrastive Learning for Unpaired Image-to-Image TranslationTaesung Park, Alexei A. Efros, Richard Zhang, Jun-Yan Zhu · 2020
  62. UNIT-DDPM: UNpaired Image Translation with Denoising Diffusion Probabilistic ModelsHiroshi Sasaki, Chris G. Willcocks, Toby P. Breckon · 2021
  63. Dual Contrastive Learning for Unsupervised Image-to-Image TranslationJunlin Han, Mehrdad Shoeiby, Lars Petersson, Mohammad Ali Armin · 2021
  64. ILVR: Conditioning Method for Denoising Diffusion Probabilistic ModelsJooyoung Choi, Sungwon Kim, Yonghyun Jeong, Youngjune Gwon, Sungroh Yoon · 2021
  65. Dual Diffusion Implicit Bridges for Image-to-Image TranslationXuan Su, Jiaming Song, Chenlin Meng, Stefano Ermon · 2022
  66. Unsupervised Medical Image Translation with Adversarial Diffusion ModelsMuzaffer Özbey, Onat Dalmaz, Salman UH Dar, Hasan A Bedel, Şaban Özturk, Alper Güngör, Tolga Çukur · 2022
  67. Diffusion-based Image Translation using Disentangled Style and Content RepresentationGihyun Kwon, Jong Chul Ye · 2022
  68. Unpaired Image-to-Image Translation via Neural Schrödinger BridgeBeomsu Kim, Gihyun Kwon, Kwanyoung Kim, Jong Chul Ye · 2023
  69. One-Step Image Translation with Text-to-Image ModelsGaurav Parmar, Taesung Park, Srinivasa Narasimhan, Jun-Yan Zhu · 2024
  70. Contrast-X: A Multi-Modal Contrast Image Synthesis Benchmark and Universal Modality Flow MatchingYifan Chen, Fei Yin, Hao Chen, Jia Wu, Chao Li · 2026
  71. Interpreting the Latent Space of GANs for Semantic Face EditingYujun Shen, Jinjin Gu, Xiaoou Tang, Bolei Zhou · 2019
  72. GANSpace: Discovering Interpretable GAN ControlsErik Härkönen, Aaron Hertzmann, Jaakko Lehtinen, Sylvain Paris · 2020
  73. StyleFlow: Attribute-conditioned Exploration of StyleGAN-Generated Images using Conditional Continuous Normalizing FlowsRameen Abdal, Peihao Zhu, Niloy Mitra, Peter Wonka · 2020
  74. StyleCLIP: Text-Driven Manipulation of StyleGAN ImageryOr Patashnik, Zongze Wu, Eli Shechtman, Daniel Cohen-Or, Dani Lischinski · 2021
  75. StyleGAN-NADA: CLIP-Guided Domain Adaptation of Image GeneratorsRinon Gal, Or Patashnik, Haggai Maron, Gal Chechik, Daniel Cohen-Or · 2021
  76. SDEdit: Guided Image Synthesis and Editing with Stochastic Differential EquationsChenlin Meng, Yutong He, Yang Song, Jiaming Song, Jiajun Wu, Jun-Yan Zhu, Stefano Ermon · 2021
  77. Blended Diffusion for Text-driven Editing of Natural ImagesOmri Avrahami, Dani Lischinski, Ohad Fried · 2021
  78. Prompt-to-Prompt Image Editing with Cross Attention ControlAmir Hertz, Ron Mokady, Jay Tenenbaum, Kfir Aberman, Yael Pritch, Daniel Cohen-Or · 2022
  79. Imagic: Text-Based Real Image Editing with Diffusion ModelsBahjat Kawar, Shiran Zada, Oran Lang, Omer Tov, Huiwen Chang, Tali Dekel, Inbar Mosseri, Michal Irani · 2022
  80. DiffEdit: Diffusion-based semantic image editing with mask guidanceGuillaume Couairon, Jakob Verbeek, Holger Schwenk, Matthieu Cord · 2022
  81. Null-text Inversion for Editing Real Images using Guided Diffusion ModelsRon Mokady, Amir Hertz, Kfir Aberman, Yael Pritch, Daniel Cohen-Or · 2022
  82. Plug-and-Play Diffusion Features for Text-Driven Image-to-Image TranslationNarek Tumanyan, Michal Geyer, Shai Bagon, Tali Dekel · 2022
  83. MasaCtrl: Tuning-Free Mutual Self-Attention Control for Consistent Image Synthesis and EditingMingdeng Cao, Xintao Wang, Zhongang Qi, Ying Shan, Xiaohu Qie, Yinqiang Zheng · 2023
  84. Drag Your GAN: Interactive Point-based Manipulation on the Generative Image ManifoldXingang Pan, Ayush Tewari, Thomas Leimkühler, Lingjie Liu, Abhimitra Meka, Christian Theobalt · 2023
  85. DragDiffusion: Harnessing Diffusion Models for Interactive Point-based Image EditingYujun Shi, Chuhui Xue, Jun Hao Liew, Jiachun Pan, Hanshu Yan, Wenqing Zhang, Vincent Y. F. Tan, Song Bai · 2023
  86. LEDITS++: Limitless Image Editing using Text-to-Image ModelsManuel Brack, Felix Friedrich, Katharina Kornmeier, Linoy Tsaban, Patrick Schramowski, Kristian Kersting, Apolinário Passos · 2023
  87. MedEdit: Counterfactual Diffusion-based Image Editing on Brain MRIMalek Ben Alaya, Daniel M. Lang, Benedikt Wiestler, Julia A. Schnabel, Cosmin I. Bercea · 2024
  88. FLUX.1 Kontext: Flow Matching for In-Context Image Generation and Editing in Latent SpaceBlack Forest Labs, Stephen Batifol, Andreas Blattmann, Frederic Boesel, Saksham Consul, Cyril Diagne, Tim Dockhorn, Jack English, Zion English, Patrick Esser, Sumith Kulal, Kyle Lacey, Yam Levi, Cheng Li, Dominik Lorenz, Jonas Müller, Dustin Podell, Robin Rombach, Harry Saini, Axel Sauer, Luke Smith · 2025
  89. On hallucinations in tomographic image reconstructionSayantan Bhadra, Varun A. Kelkar, Frank J. Brooks, Mark A. Anastasio · 2020
  90. Generative Image Inpainting with Contextual AttentionJiahui Yu, Zhe Lin, Jimei Yang, Xiaohui Shen, Xin Lu, Thomas S. Huang · 2018
  91. Image Inpainting for Irregular Holes Using Partial ConvolutionsGuilin Liu, Fitsum A. Reda, Kevin J. Shih, Ting-Chun Wang, Andrew Tao, Bryan Catanzaro · 2018
  92. ESRGAN: Enhanced Super-Resolution Generative Adversarial NetworksXintao Wang, Ke Yu, Shixiang Wu, Jinjin Gu, Yihao Liu, Chao Dong, Chen Change Loy, Yu Qiao, Xiaoou Tang · 2018
  93. EdgeConnect: Generative Image Inpainting with Adversarial Edge LearningKamyar Nazeri, Eric Ng, Tony Joseph, Faisal Z. Qureshi, Mehran Ebrahimi · 2019
  94. Pluralistic Image CompletionChuanxia Zheng, Tat-Jen Cham, Jianfei Cai · 2019
  95. SRFlow: Learning the Super-Resolution Space with Normalizing FlowAndreas Lugmayr, Martin Danelljan, Luc Van Gool, Radu Timofte · 2020
  96. Towards Real-World Blind Face Restoration with Generative Facial PriorXintao Wang, Yu Li, Honglun Zhang, Ying Shan · 2021
  97. Image Super-Resolution via Iterative RefinementChitwan Saharia, Jonathan Ho, William Chan, Tim Salimans, David J. Fleet, Mohammad Norouzi · 2021
  98. Real-ESRGAN: Training Real-World Blind Super-Resolution with Pure Synthetic DataXintao Wang, Liangbin Xie, Chao Dong, Ying Shan · 2021
  99. Resolution-robust Large Mask Inpainting with Fourier ConvolutionsRoman Suvorov, Elizaveta Logacheva, Anton Mashikhin, Anastasia Remizova, Arsenii Ashukha, Aleksei Silvestrov, Naejin Kong, Harshith Goka, Kiwoong Park, Victor Lempitsky · 2021
  100. RePaint: Inpainting using Denoising Diffusion Probabilistic ModelsAndreas Lugmayr, Martin Danelljan, Andres Romero, Fisher Yu, Radu Timofte, Luc Van Gool · 2022
  101. Towards Robust Blind Face Restoration with Codebook Lookup TransformerShangchen Zhou, Kelvin C. K. Chan, Chongyi Li, Chen Change Loy · 2022
  102. Exploiting Diffusion Prior for Real-World Image Super-ResolutionJianyi Wang, Zongsheng Yue, Shangchen Zhou, Kelvin C. K. Chan, Chen Change Loy · 2023
  103. DiffBIR: Towards Blind Image Restoration with Generative Diffusion PriorXinqi Lin, Jingwen He, Ziyan Chen, Zhaoyang Lyu, Bo Dai, Fanghua Yu, Wanli Ouyang, Yu Qiao, Chao Dong · 2023
  104. SinSR: Diffusion-Based Image Super-Resolution in a Single StepYufei Wang, Wenhan Yang, Xinyuan Chen, Yaohui Wang, Lanqing Guo, Lap-Pui Chau, Ziwei Liu, Yu Qiao, Alex C. Kot, Bihan Wen · 2023
  105. SeeSR: Towards Semantics-Aware Real-World Image Super-ResolutionRongyuan Wu, Tao Yang, Lingchen Sun, Zhengqiang Zhang, Shuai Li, Lei Zhang · 2023
  106. Scaling Up to Excellence: Practicing Model Scaling for Photo-Realistic Image Restoration In the WildFanghua Yu, Jinjin Gu, Zheyuan Li, Jinfan Hu, Xiangtao Kong, Xintao Wang, Jingwen He, Yu Qiao, Chao Dong · 2024
  107. One-Step Effective Diffusion Network for Real-World Image Super-ResolutionRongyuan Wu, Lingchen Sun, Zhiyuan Ma, Lei Zhang · 2024
  108. DRIFT: Difficulty-aware Rectified Flows for Through-plane MRI Super-ResolutionYoonseok Choi, Eun-Gyu Ha, Daniel Kim, Mohammed A. Al-masni, Ming-Hsuan Yang, Dong-Hyun Kim · 2026
  109. Diffusion Active Learning: Towards Data-Driven Experimental Design in Computed TomographyLuis Barba, Johannes Kirschner, Tomas Aidukas, Manuel Guizar-Sicairos, Benjamín Béjar · 2025
  110. Task-Aware Compressed Sensing with Generative Adversarial NetworksMaya Kabkab, Pouya Samangouei, Rama Chellappa · 2018
  111. Modeling Sparse Deviations for Compressed Sensing using Generative ModelsManik Dhar, Aditya Grover, Stefano Ermon · 2018
  112. SEGAN: Structure-Enhanced Generative Adversarial Network for Compressed Sensing MRI ReconstructionZhongnian Li, Tao Zhang, Peng Wan, Daoqiang Zhang · 2019
  113. Compressed Sensing via Measurement-Conditional Generative ModelsKyung-Su Kim, Jung Hyun Lee, Eunho Yang · 2020
  114. Robust Compressed Sensing MRI with Deep Generative PriorsAjil Jalal, Marius Arvinte, Giannis Daras, Eric Price, Alexandros G. Dimakis, Jonathan I. Tamir · 2021
  115. Score-based diffusion models for accelerated MRIHyungjin Chung, Jong Chul Ye · 2021
  116. Improving Diffusion Models for Inverse Problems using Manifold ConstraintsHyungjin Chung, Byeongsu Sim, Dohoon Ryu, Jong Chul Ye · 2022
  117. Zero-Shot Image Restoration Using Denoising Diffusion Null-Space ModelYinhuai Wang, Jiwen Yu, Jian Zhang · 2022
  118. Decomposed Diffusion Sampler for Accelerating Large-Scale Inverse ProblemsHyungjin Chung, Suhyeon Lee, Jong Chul Ye · 2023
  119. A Variational Perspective on Solving Inverse Problems with Diffusion ModelsMorteza Mardani, Jiaming Song, Jan Kautz, Arash Vahdat · 2023
  120. Tweedie Moment Projected Diffusions For Inverse ProblemsBenjamin Boys, Mark Girolami, Jakiw Pidstrigach, Sebastian Reich, Alan Mosca, O. Deniz Akyildiz · 2023
  121. CT Reconstruction using Diffusion Posterior Sampling conditioned on a Nonlinear Measurement ModelShudong Li, Xiao Jiang, Matthew Tivnan, Grace J. Gang, Yuan Shen, J. Webster Stayman · 2023
  122. Ambient Diffusion Posterior Sampling: Solving Inverse Problems with Diffusion Models Trained on Corrupted DataAsad Aali, Giannis Daras, Brett Levac, Sidharth Kumar, Alexandros G. Dimakis, Jonathan I. Tamir · 2024
  123. Principled Probabilistic Imaging using Diffusion Models as Plug-and-Play PriorsZihui Wu, Yu Sun, Yifan Chen, Bingliang Zhang, Yisong Yue, Katherine L. Bouman · 2024
  124. Improving Diffusion Inverse Problem Solving with Decoupled Noise AnnealingBingliang Zhang, Wenda Chu, Julius Berner, Chenlin Meng, Anima Anandkumar, Yang Song · 2024
  125. Outlier-robust Diffusion Posterior Sampling for Bayesian Inverse ProblemsYiming Yang, Xiaoyuan Cheng, Yi He, Kaiyu Li, Wenxuan Yuan, Zhuo Sun · 2026
  126. Piecewise Dynamic Diffusion Regularization for Reconstruction of Cardiac Cine MRIFlorian Fürnrohr, Reinhard Heckel · 2026
  127. EchoWorld: Learning Motion-Aware World Models for Echocardiography Probe GuidanceYue, Yang, Wang, Yulin, Jiang, Haojun, Liu, Pan, Song, Shiji, Huang, Gao · 2025
  128. Stochastic Adversarial Video PredictionAlex X. Lee, Richard Zhang, Frederik Ebert, Pieter Abbeel, Chelsea Finn, Sergey Levine · 2018
  129. Video-to-Video SynthesisTing-Chun Wang, Ming-Yu Liu, Jun-Yan Zhu, Guilin Liu, Andrew Tao, Jan Kautz, Bryan Catanzaro · 2018
  130. Adversarial Video Generation on Complex DatasetsAidan Clark, Jeff Donahue, Karen Simonyan · 2019
  131. VideoGPT: Video Generation using VQ-VAE and TransformersWilson Yan, Yunzhi Zhang, Pieter Abbeel, Aravind Srinivas · 2021
  132. MotionDiffuse: Text-Driven Human Motion Generation with Diffusion ModelMingyuan Zhang, Zhongang Cai, Liang Pan, Fangzhou Hong, Xinying Guo, Lei Yang, Ziwei Liu · 2022
  133. Make-A-Video: Text-to-Video Generation without Text-Video DataUriel Singer, Adam Polyak, Thomas Hayes, Xi Yin, Jie An, Songyang Zhang, Qiyuan Hu, Harry Yang, Oron Ashual, Oran Gafni, Devi Parikh, Sonal Gupta, Yaniv Taigman · 2022
  134. Human Motion Diffusion ModelGuy Tevet, Sigal Raab, Brian Gordon, Yonatan Shafir, Daniel Cohen-Or, Amit H. Bermano · 2022
  135. Imagen Video: High Definition Video Generation with Diffusion ModelsJonathan Ho, William Chan, Chitwan Saharia, Jay Whang, Ruiqi Gao, Alexey Gritsenko, Diederik P. Kingma, Ben Poole, Mohammad Norouzi, David J. Fleet, Tim Salimans · 2022
  136. Phenaki: Variable Length Video Generation From Open Domain Textual DescriptionRuben Villegas, Mohammad Babaeizadeh, Pieter-Jan Kindermans, Hernan Moraldo, Han Zhang, Mohammad Taghi Saffar, Santiago Castro, Julius Kunze, Dumitru Erhan · 2022
  137. Tune-A-Video: One-Shot Tuning of Image Diffusion Models for Text-to-Video GenerationJay Zhangjie Wu, Yixiao Ge, Xintao Wang, Weixian Lei, Yuchao Gu, Yufei Shi, Wynne Hsu, Ying Shan, Xiaohu Qie, Mike Zheng Shou · 2022
  138. T2M-GPT: Generating Human Motion from Textual Descriptions with Discrete RepresentationsJianrong Zhang, Yangsong Zhang, Xiaodong Cun, Shaoli Huang, Yong Zhang, Hongwei Zhao, Hongtao Lu, Xi Shen · 2023
  139. Text2Video-Zero: Text-to-Image Diffusion Models are Zero-Shot Video GeneratorsLevon Khachatryan, Andranik Movsisyan, Vahram Tadevosyan, Roberto Henschel, Zhangyang Wang, Shant Navasardyan, Humphrey Shi · 2023
  140. Align your Latents: High-Resolution Video Synthesis with Latent Diffusion ModelsAndreas Blattmann, Robin Rombach, Huan Ling, Tim Dockhorn, Seung Wook Kim, Sanja Fidler, Karsten Kreis · 2023
  141. AnimateDiff: Animate Your Personalized Text-to-Image Diffusion Models without Specific TuningYuwei Guo, Ceyuan Yang, Anyi Rao, Zhengyang Liang, Yaohui Wang, Yu Qiao, Maneesh Agrawala, Dahua Lin, Bo Dai · 2023
  142. Stable Video Diffusion: Scaling Latent Video Diffusion Models to Large DatasetsAndreas Blattmann, Tim Dockhorn, Sumith Kulal, Daniel Mendelevitch, Maciej Kilian, Dominik Lorenz, Yam Levi, Zion English, Vikram Voleti, Adam Letts, Varun Jampani, Robin Rombach · 2023
  143. Lumiere: A Space-Time Diffusion Model for Video GenerationOmer Bar-Tal, Hila Chefer, Omer Tov, Charles Herrmann, Roni Paiss, Shiran Zada, Ariel Ephrat, Junhwa Hur, Guanghui Liu, Amit Raj, Yuanzhen Li, Michael Rubinstein, Tomer Michaeli, Oliver Wang, Deqing Sun, Tali Dekel, Inbar Mosseri · 2024
  144. CogVideoX: Text-to-Video Diffusion Models with An Expert TransformerZhuoyi Yang, Jiayan Teng, Wendi Zheng, Ming Ding, Shiyu Huang, Jiazheng Xu, Yuanming Yang, Wenyi Hong, Xiaohan Zhang, Guanyu Feng, Da Yin, Yuxuan Zhang, Weihan Wang, Yean Cheng, Bin Xu, Xiaotao Gu, Yuxiao Dong, Jie Tang · 2024
  145. CardioDiT: Latent Diffusion Transformers for 4D Cardiac MRI SynthesisMarvin Seyfarth, Sarah Kaye Müller, Arman Ghanaat, Isabelle Ayx, Fabian Fastenrath, Philipp Wild, Alexander Hertel, Theano Papavassiliu, Salman Ul Hassan Dar, Sandy Engelhardt · 2026
  146. Seedance 2.0: Advancing Video Generation for World ComplexityTeam Seedance, De Chen, Liyang Chen, Xin Chen, Ying Chen, Zhuo Chen, Zhuowei Chen, Feng Cheng, Tianheng Cheng, Yufeng Cheng, Mojie Chi, Xuyan Chi, Jian Cong, Qinpeng Cui, Fei Ding, Qide Dong, Yujiao Du, Haojie Duanmu, Junliang Fan, Jiarui Fang, Jing Fang, Zetao Fang, Chengjian Feng, Yu Gao, Diandian Gu, Dong Guo, Hanzhong Guo, Qiushan Guo, Boyang Hao, Hongxiang Hao, Haoxun He, Jiaao He, Qian He, Tuyen Hoang, Heng Hu, Ruoqing Hu, Yuxiang Hu, Jiancheng Huang, Weilin Huang, Zhaoyang Huang, Zhongyi Huang, Jishuo Jin, Ming Jing, Ashley Kim, Shanshan Lao, Yichong Leng, Bingchuan Li, Gen Li, Haifeng Li, Huixia Li, Jiashi Li, Ming Li, Xiaojie Li, Xingxing Li, Yameng Li, Yiying Li, Yu Li, Yueyan Li, Chao Liang, Han Liang, Jianzhong Liang, Ying Liang, Wang Liao, J. H. Lien, Shanchuan Lin, Xi Lin, Feng Ling, Yue Ling, Fangfang Liu, Jiawei Liu, Jihao Liu, Jingtuo Liu, Shu Liu, Sichao Liu, Wei Liu, Xue Liu, Zuxi Liu, Ruijie Lu, Lecheng Lyu, Jingting Ma, Tianxiang Ma, Xiaonan Nie, Jingzhe Ning, Junjie Pan, Xitong Pan, Ronggui Peng, Xueqiong Qu, Yuxi Ren, Yuchen Shen, Guang Shi, Lei Shi, Yinglong Song, Fan Sun, Li Sun, Renfei Sun, Wenjing Tang, Boyang Tao, Zirui Tao, Dongliang Wang, Feng Wang, Hulin Wang, Ke Wang, Qingyi Wang, Rui Wang, Shuai Wang, Shulei Wang, Weichen Wang, Xuanda Wang, Yanhui Wang, Yue Wang, Yuping Wang, Yuxuan Wang, Zijie Wang, Ziyu Wang, Guoqiang Wei, Meng Wei, Di Wu, Guohong Wu, Hanjie Wu, Huachao Wu, Jian Wu, Jie Wu, Ruolan Wu, Shaojin Wu, Xiaohu Wu, Xinglong Wu, Yonghui Wu, Ruiqi Xia, Xin Xia, Xuefeng Xiao, Shuang Xu, Bangbang Yang, Jiaqi Yang, Runkai Yang, Tao Yang, Yihang Yang, Zhixian Yang, Ziyan Yang, Fulong Ye, Bingqian Yi, Xing Yin, Yongbin You, Linxiao Yuan, Weihong Zeng, Xuejiao Zeng, Yan Zeng, Siyu Zhai, Zhonghua Zhai, Bowen Zhang, Chenlin Zhang, Heng Zhang, Jun Zhang, Manlin Zhang, Peiyuan Zhang, Shuo Zhang, Xiaohe Zhang, Xiaoying Zhang, Xinyan Zhang, Xinyi Zhang, Yichi Zhang, Zixiang Zhang, Haiyu Zhao, Huating Zhao, Liming Zhao, Yian Zhao, Guangcong Zheng, Jianbin Zheng, Xiaozheng Zheng, Zerong Zheng, Kuan Zhu, Feilong Zuo · 2026
  147. Semantic Image Synthesis with Spatially-Adaptive NormalizationTaesung Park, Ming-Yu Liu, Ting-Chun Wang, Jun-Yan Zhu · 2019
  148. RoentGen: Vision-Language Foundation Model for Chest X-ray GenerationPierre Chambon, Christian Bluethgen, Jean-Benoit Delbrouck, Rogier Van der Sluijs, Małgorzata Połacin, Juan Manuel Zambrano Chaves, Tanishq Mathew Abraham, Shivanshu Purohit, Curtis P. Langlotz, Akshay Chaudhari · 2022
  149. Adding Conditional Control to Text-to-Image Diffusion ModelsLvmin Zhang, Anyi Rao, Maneesh Agrawala · 2023
  150. Image Generation from LayoutBo Zhao, Lili Meng, Weidong Yin, Leonid Sigal · 2018
  151. Object-driven Text-to-Image Synthesis via Adversarial TrainingWenbo Li, Pengchuan Zhang, Lei Zhang, Qiuyuan Huang, Xiaodong He, Siwei Lyu, Jianfeng Gao · 2019
  152. DM-GAN: Dynamic Memory Generative Adversarial Networks for Text-to-Image SynthesisMinfeng Zhu, Pingbo Pan, Wei Chen, Yi Yang · 2019
  153. Make-A-Scene: Scene-Based Text-to-Image Generation with Human PriorsOran Gafni, Adam Polyak, Oron Ashual, Shelly Sheynin, Devi Parikh, Yaniv Taigman · 2022
  154. GLIGEN: Open-Set Grounded Text-to-Image GenerationYuheng Li, Haotian Liu, Qingyang Wu, Fangzhou Mu, Jianwei Yang, Jianfeng Gao, Chunyuan Li, Yong Jae Lee · 2023
  155. T2I-Adapter: Learning Adapters to Dig out More Controllable Ability for Text-to-Image Diffusion ModelsChong Mou, Xintao Wang, Liangbin Xie, Yanze Wu, Jian Zhang, Zhongang Qi, Ying Shan, Xiaohu Qie · 2023
  156. Lens: Rethinking Training Efficiency for Foundational Text-to-Image ModelsDong Chen, Fangyun Wei, Ziyu Wan, Dongdong Chen, Jiawei Zhang, Jinjing Zhao, Sirui Zhang, Yang Yue, Zhiyang Liang, Baining Guo, Chong Luo, Jianmin Bao, Ji Li, Lei Shi, Qinhong Yang, Xiuyu Wu, Xuelu Feng, Yan Lu, Yanchen Dong, Yitong Wang, Yunuo Chen · 2026
  157. SeFi-Image: A Text-to-Image Foundation Model with Semantic-First DiffusionRuoyu Feng, Jinming Liu, Yuqi Wang, Xin Cheng, Boyuan Liu, Shanglin Li, Hanshen Zhu, Wenfeng Lin, Mingyu Guo, Xin Jin · 2026
  158. CogView: Mastering Text-to-Image Generation via TransformersMing Ding, Zhuoyi Yang, Wenyi Hong, Wendi Zheng, Chang Zhou, Da Yin, Junyang Lin, Xu Zou, Zhou Shao, Hongxia Yang, Jie Tang · 2021
  159. PixArt-α: Fast Training of Diffusion Transformer for Photorealistic Text-to-Image SynthesisJunsong Chen, Jincheng Yu, Chongjian Ge, Lewei Yao, Enze Xie, Yue Wu, Zhongdao Wang, James Kwok, Ping Luo, Huchuan Lu, Zhenguo Li · 2023
  160. SANA: Efficient High-Resolution Image Synthesis with Linear Diffusion TransformersEnze Xie, Junsong Chen, Junyu Chen, Han Cai, Haotian Tang, Yujun Lin, Zhekai Zhang, Muyang Li, Ligeng Zhu, Yao Lu, Song Han · 2024
  161. Janus-Pro: Unified Multimodal Understanding and Generation with Data and Model ScalingXiaokang Chen, Zhiyu Wu, Xingchao Liu, Zizheng Pan, Wen Liu, Zhenda Xie, Xingkai Yu, Chong Ruan · 2025
  162. HunyuanImage 3.0 Technical ReportTencent Hunyuan Foundation Model Team · 2025
  163. Z-Image: An Efficient Image Generation Foundation Model with Single-Stream Diffusion TransformerZ-Image Team, Huanqia Cai, Sihan Cao, Ruoyi Du, Peng Gao, Aiming Hao, Steven Hoi, Zhaohui Hou, Shijie Huang, Dengyang Jiang, Yuming Jiang, Xin Jin, Liangchen Li, Zhen Li, Zhong-Yu Li, David Liu, Dongyang Liu, Qilong Wu, Feng Yu, Zechao Zhan, Chi Zhang, Shifeng Zhang, Ruikai Zhou, Shilin Zhou · 2025
  164. Semantic Palette: Guiding Scene Generation with Class ProportionsGuillaume Le Moing, Tuan-Hung Vu, Himalaya Jain, Patrick Pérez, Matthieu Cord · 2021
  165. Attend-and-Excite: Attention-Based Semantic Guidance for Text-to-Image Diffusion ModelsHila Chefer, Yuval Alaluf, Yael Vinker, Lior Wolf, Daniel Cohen-Or · 2023
  166. BoxDiff: Text-to-Image Synthesis with Training-Free Box-Constrained DiffusionJinheng Xie, Yuexiang Li, Yawen Huang, Haozhe Liu, Wentian Zhang, Yefeng Zheng, Mike Zheng Shou · 2023
  167. Style Aligned Image Generation via Shared AttentionAmir Hertz, Andrey Voynov, Shlomi Fruchter, Daniel Cohen-Or · 2023
  168. FreeControl: Training-Free Spatial Control of Any Text-to-Image Diffusion Model with Any ConditionSicheng Mo, Fangzhou Mu, Kuan Heng Lin, Yanli Liu, Bochen Guan, Yin Li, Bolei Zhou · 2023
  169. LGTM: Training-Free Light-Guided Text-to-Image Diffusion Model via Initial Noise ManipulationRyugo Morita, Stanislav Frolov, Brian Bernhard Moser, Ko Watanabe, Riku Takahashi, Andreas Dengel · 2026
  170. IDDM: Identity-Decoupled Personalized Diffusion Models with a Tunable Privacy-Utility Trade-offLinyan Dai, Xinwei Zhang, Haoyang Li, Qingqing Ye, Haibo Hu · 2026
  171. DreamBooth: Fine Tuning Text-to-Image Diffusion Models for Subject-Driven GenerationNataniel Ruiz, Yuanzhen Li, Varun Jampani, Yael Pritch, Michael Rubinstein, Kfir Aberman · 2022
  172. EndoFSA: Endoscopic Few-Shot Image Generation via Rank-Constrained Parameter AdaptationPanagiota Gatoula, Grigoris Karypidis, Dimitris K. Iakovidis · 2026
  173. Training Generative Adversarial Networks with Limited DataTero Karras, Miika Aittala, Janne Hellsten, Samuli Laine, Jaakko Lehtinen, Timo Aila · 2020
  174. Transferring GANs: generating images from limited dataYaxing Wang, Chenshen Wu, Luis Herranz, Joost van de Weijer, Abel Gonzalez-Garcia, Bogdan Raducanu · 2018
  175. MineGAN: effective knowledge transfer from GANs to target domains with few imagesYaxing Wang, Abel Gonzalez-Garcia, David Berga, Luis Herranz, Fahad Shahbaz Khan, Joost van de Weijer · 2019
  176. Freeze the Discriminator: a Simple Baseline for Fine-Tuning GANsSangwoo Mo, Minsu Cho, Jinwoo Shin · 2020
  177. Few-Shot Diffusion ModelsGiorgio Giannone, Didrik Nielsen, Ole Winther · 2022
  178. An Image is Worth One Word: Personalizing Text-to-Image Generation using Textual InversionRinon Gal, Yuval Alaluf, Yuval Atzmon, Or Patashnik, Amit H. Bermano, Gal Chechik, Daniel Cohen-Or · 2022
  179. DreamArtist: Towards Controllable One-Shot Text-to-Image Generation via Contrastive Prompt-TuningZiyi Dong, Pengxu Wei, Liang Lin · 2022
  180. Multi-Concept Customization of Text-to-Image DiffusionNupur Kumari, Bingliang Zhang, Richard Zhang, Eli Shechtman, Jun-Yan Zhu · 2022
  181. Cones: Concept Neurons in Diffusion Models for Customized GenerationZhiheng Liu, Ruili Feng, Kai Zhu, Yifei Zhang, Kecheng Zheng, Yu Liu, Deli Zhao, Jingren Zhou, Yang Cao · 2023
  182. SVDiff: Compact Parameter Space for Diffusion Fine-TuningLigong Han, Yinxiao Li, Han Zhang, Peyman Milanfar, Dimitris Metaxas, Feng Yang · 2023
  183. DreamBooth3D: Subject-Driven Text-to-3D GenerationAmit Raj, Srinivas Kaza, Ben Poole, Michael Niemeyer, Nataniel Ruiz, Ben Mildenhall, Shiran Zada, Kfir Aberman, Michael Rubinstein, Jonathan Barron, Yuanzhen Li, Varun Jampani · 2023
  184. Key-Locked Rank One Editing for Text-to-Image PersonalizationYoad Tewel, Rinon Gal, Gal Chechik, Yuval Atzmon · 2023
  185. DisenBooth: Identity-Preserving Disentangled Tuning for Subject-Driven Text-to-Image GenerationHong Chen, Yipeng Zhang, Simin Wu, Xin Wang, Xuguang Duan, Yuwei Zhou, Wenwu Zhu · 2023
  186. Mix-of-Show: Decentralized Low-Rank Adaptation for Multi-Concept Customization of Diffusion ModelsYuchao Gu, Xintao Wang, Jay Zhangjie Wu, Yujun Shi, Yunpeng Chen, Zihan Fan, Wuyou Xiao, Rui Zhao, Shuning Chang, Weijia Wu, Yixiao Ge, Ying Shan, Mike Zheng Shou · 2023
  187. HyperDreamBooth: HyperNetworks for Fast Personalization of Text-to-Image ModelsNataniel Ruiz, Yuanzhen Li, Varun Jampani, Wei Wei, Tingbo Hou, Yael Pritch, Neal Wadhwa, Michael Rubinstein, Kfir Aberman · 2023
  188. APT: Adaptive Personalized Training for Diffusion Models with Limited DataJungWoo Chae, Jiyoon Kim, JaeWoong Choi, Kyungyul Kim, Sangheum Hwang · 2025
  189. Uni-DAD: Unified Distillation and Adaptation of Diffusion Models for Few-step Few-shot Image GenerationYara Bahram, Mélodie Desbos, Mohammadhadi Shateri, Eric Granger · 2025
  190. ControlVideo: Training-free Controllable Text-to-Video GenerationYabo Zhang, Yuxiang Wei, Dongsheng Jiang, Xiaopeng Zhang, Wangmeng Zuo, Qi Tian · 2023
  191. ZIPP:Zero-shot Image Personalization from PersonasHarini SI, Somesh Singh, Yaman Kumar Singla, David Doermann, Rajiv Ratn Shah · 2026
  192. Training-Free Inpainting Across Domains with a Frozen Text-to-Image Diffusion ModelZhenhuan Wang, Fengyi Yuan · 2026
  193. Differentiable Augmentation for Data-Efficient GAN TrainingShengyu Zhao, Zhijian Liu, Ji Lin, Jun-Yan Zhu, Song Han · 2020
  194. Towards Faster and Stabilized GAN Training for High-fidelity Few-shot Image SynthesisBingchen Liu, Yizhe Zhu, Kunpeng Song, Ahmed Elgammal · 2021
  195. Data-Efficient GAN Training Beyond (Just) Augmentations: A Lottery Ticket PerspectiveTianlong Chen, Yu Cheng, Zhe Gan, Jingjing Liu, Zhangyang Wang · 2021
  196. Regularizing Generative Adversarial Networks under Limited DataHung-Yu Tseng, Lu Jiang, Ce Liu, Ming-Hsuan Yang, Weilong Yang · 2021
  197. Projected GANs Converge FasterAxel Sauer, Kashyap Chitta, Jens Müller, Andreas Geiger · 2021
  198. Diffusion-GAN: Training GANs with DiffusionZhendong Wang, Huangjie Zheng, Pengcheng He, Weizhu Chen, Mingyuan Zhou · 2022
  199. CHAIN: Enhancing Generalization in Data-Efficient GANs via lipsCHitz continuity constrAIned NormalizationYao Ni, Piotr Koniusz · 2024
  200. Pruning then Reweighting: Towards Data-Efficient Training of Diffusion ModelsYize Li, Yihua Zhang, Sijia Liu, Xue Lin · 2024
  201. Random Conditioning with Distillation for Data-Efficient Diffusion Model CompressionDohyun Kim, Sehwan Park, Geonhee Han, Seung Wook Kim, Paul Hongsuck Seo · 2025
  202. Personalize at Test Time: Learning User Preferences for Image GenerationJiamu Bai, Jiaming Hu, Yanhong Wu, Zellux Wang · 2026
  203. One Transformer Fits All Distributions in Multi-Modal Diffusion at ScaleFan Bao, Shen Nie, Kaiwen Xue, Chongxuan Li, Shi Pu, Yaole Wang, Gang Yue, Yue Cao, Hang Su, Jun Zhu · 2023
  204. UniX: Unifying Autoregression and Diffusion for Chest X-Ray Understanding and GenerationRuiheng Zhang, Jingfeng Yao, Huangxuan Zhao, Hao Yan, Xiao He, Lei Chen, Zhou Wei, Yong Luo, Zengmao Wang, Lefei Zhang, Dacheng Tao, Bo Du · 2026
  205. JointNet: Extending Text-to-Image Diffusion for Dense Distribution ModelingJingyang Zhang, Shiwei Li, Yuanxun Lu, Tian Fang, David McKinnon, Yanghai Tsin, Long Quan, Yao Yao · 2023
  206. MedSegFactory: Text-Guided Generation of Medical Image-Mask PairsJiawei Mao, Yuhan Wang, Yucheng Tang, Daguang Xu, Kang Wang, Yang Yang, Zongwei Zhou, Yuyin Zhou · 2025
  207. OFA: Unifying Architectures, Tasks, and Modalities Through a Simple Sequence-to-Sequence Learning FrameworkPeng Wang, An Yang, Rui Men, Junyang Lin, Shuai Bai, Zhikang Li, Jianxin Ma, Chang Zhou, Jingren Zhou, Hongxia Yang · 2022
  208. Unified-IO: A Unified Model for Vision, Language, and Multi-Modal TasksJiasen Lu, Christopher Clark, Rowan Zellers, Roozbeh Mottaghi, Aniruddha Kembhavi · 2022
  209. Versatile Diffusion: Text, Images and Variations All in One Diffusion ModelXingqian Xu, Zhangyang Wang, Eric Zhang, Kai Wang, Humphrey Shi · 2022
  210. SDFusion: Multimodal 3D Shape Completion, Reconstruction, and GenerationYen-Chi Cheng, Hsin-Ying Lee, Sergey Tulyakov, Alexander Schwing, Liangyan Gui · 2022
  211. TEXTure: Text-Guided Texturing of 3D ShapesElad Richardson, Gal Metzer, Yuval Alaluf, Raja Giryes, Daniel Cohen-Or · 2023
  212. DreamLLM: Synergistic Multimodal Comprehension and CreationRunpei Dong, Chunrui Han, Yuang Peng, Zekun Qi, Zheng Ge, Jinrong Yang, Liang Zhao, Jianjian Sun, Hongyu Zhou, Haoran Wei, Xiangwen Kong, Xiangyu Zhang, Kaisheng Ma, Li Yi · 2023
  213. Unified-IO 2: Scaling Autoregressive Multimodal Models with Vision, Language, Audio, and ActionJiasen Lu, Christopher Clark, Sangho Lee, Zichen Zhang, Savya Khosla, Ryan Marten, Derek Hoiem, Aniruddha Kembhavi · 2023
  214. Show-o: One Single Transformer to Unify Multimodal Understanding and GenerationJinheng Xie, Weijia Mao, Zechen Bai, David Junhao Zhang, Weihao Wang, Kevin Qinghong Lin, Yuchao Gu, Zhijie Chen, Zhenheng Yang, Mike Zheng Shou · 2024
  215. OmniGen: Unified Image GenerationShitao Xiao, Yueze Wang, Junjie Zhou, Huaying Yuan, Xingrun Xing, Ruiran Yan, Chaofan Li, Shuting Wang, Tiejun Huang, Zheng Liu · 2024
  216. UniReal: Universal Image Generation and Editing via Learning Real-world DynamicsXi Chen, Zhifei Zhang, He Zhang, Yuqian Zhou, Soo Ye Kim, Qing Liu, Yijun Li, Jianming Zhang, Nanxuan Zhao, Yilin Wang, Hui Ding, Zhe Lin, Hengshuang Zhao · 2024
  217. Emerging Properties in Unified Multimodal PretrainingChaorui Deng, Deyao Zhu, Kunchang Li, Chenhui Gou, Feng Li, Zeyu Wang, Shu Zhong, Weihao Yu, Xiaonan Nie, Ziang Song, Guang Shi, Haoqi Fan · 2025
  218. Lance: Unified Multimodal Modeling by Multi-Task SynergyFengyi Fu, Mengqi Huang, Shaojin Wu, Yunsheng Jiang, Yufei Huo, Hao Li, Yinghang Song, Fei Ding, Jianzhu Guo, Qian He, Zheren Fu, Zhendong Mao, Yongdong Zhang · 2026
  219. UniGen-AR: Unifying Visual Generation with Auto-Regressive ModelingZhipeng Bao, Zhen Zhu, Nupur Kumari, Anurag Bagchi, Yu-Xiong Wang, Pavel Tokmakov, Martial Hebert · 2026
  220. Hunyuan3D-Buffalo 1.0: A Unified Multimodal Model for Scalable 3D Generation, Understanding, and EditingJunliang Ye, Kenkun Liu, Guocun Wang, Yang Li, Yansong Qu, Chunshi Wang, Jingwei Xu, Yunhan Yang, Zibo Zhao, Jiachen Xu, Jiaao Yu, Lifu Wang, Zhihao Liang, Xin Huang, Zhuo Chen, Chunchao Guo · 2026
  221. Any-to-Any Generation via Composable DiffusionZineng Tang, Ziyi Yang, Chenguang Zhu, Michael Zeng, Mohit Bansal · 2023
  222. Emu: Generative Pretraining in MultimodalityQuan Sun, Qiying Yu, Yufeng Cui, Fan Zhang, Xiaosong Zhang, Yueze Wang, Hongcheng Gao, Jingjing Liu, Tiejun Huang, Xinlong Wang · 2023
  223. NExT-GPT: Any-to-Any Multimodal LLMShengqiong Wu, Hao Fei, Leigang Qu, Wei Ji, Tat-Seng Chua · 2023
  224. CoDi-2: In-Context, Interleaved, and Interactive Any-to-Any GenerationZineng Tang, Ziyi Yang, Mahmoud Khademi, Yang Liu, Chenguang Zhu, Mohit Bansal · 2023
  225. AnyGPT: Unified Multimodal LLM with Discrete Sequence ModelingJun Zhan, Junqi Dai, Jiasheng Ye, Yunhua Zhou, Dong Zhang, Zhigeng Liu, Xin Zhang, Ruibin Yuan, Ge Zhang, Linyang Li, Hang Yan, Jie Fu, Tao Gui, Tianxiang Sun, Yu-Gang Jiang, Xipeng Qiu · 2024
  226. Chameleon: Mixed-Modal Early-Fusion Foundation ModelsChameleon Team · 2024
  227. Transfusion: Predict the Next Token and Diffuse Images with One Multi-Modal ModelChunting Zhou, Lili Yu, Arun Babu, Kushal Tirumala, Michihiro Yasunaga, Leonid Shamis, Jacob Kahn, Xuezhe Ma, Luke Zettlemoyer, Omer Levy · 2024
  228. Emu3: Next-Token Prediction is All You NeedXinlong Wang, Xiaosong Zhang, Zhengxiong Luo, Quan Sun, Yufeng Cui, Jinsheng Wang, Fan Zhang, Yueze Wang, Zhen Li, Qiying Yu, Yingli Zhao, Yulong Ao, Xuebin Min, Tao Li, Boya Wu, Bo Zhao, Bowen Zhang, Liangdong Wang, Guang Liu, Zheqi He, Xi Yang, Jingjing Liu, Yonghua Lin, Tiejun Huang, Zhongyuan Wang · 2024
  229. OmniFlow: Any-to-Any Generation with Multi-Modal Rectified FlowsShufan Li, Konstantinos Kallidromitis, Akash Gokul, Zichun Liao, Yusuke Kato, Kazuki Kozuka, Aditya Grover · 2024
  230. MUNI: Multimodal Unified Latent Diffusion for Coherent Any-to-Any GenerationKyeongmin Yeo, Yunhong Min, Minhyuk Sung · 2026
  231. High Quality Facial Surface and Texture Synthesis via Generative Adversarial NetworksRon Slossberg, Gil Shamai, Ron Kimmel · 2018
  232. DatasetGAN: Efficient Labeled Data Factory with Minimal Human EffortYuxuan Zhang, Huan Ling, Jun Gao, Kangxue Yin, Jean-Francois Lafleche, Adela Barriuso, Antonio Torralba, Sanja Fidler · 2021
  233. BigDatasetGAN: Synthesizing ImageNet with Pixel-wise AnnotationsDaiqing Li, Huan Ling, Seung Wook Kim, Karsten Kreis, Adela Barriuso, Sanja Fidler, Antonio Torralba · 2022
  234. GET3D: A Generative Model of High Quality 3D Textured Shapes Learned from ImagesJun Gao, Tianchang Shen, Zian Wang, Wenzheng Chen, Kangxue Yin, Daiqing Li, Or Litany, Zan Gojcic, Sanja Fidler · 2022
  235. LDM3D: Latent Diffusion Model for 3DGabriela Ben Melech Stan, Diana Wofk, Scottie Fox, Alex Redden, Will Saxton, Jean Yu, Estelle Aflalo, Shao-Yen Tseng, Fabio Nonato, Matthias Muller, Vasudev Lal · 2023
  236. MatFuse: Controllable Material Generation with Diffusion ModelsGiuseppe Vecchio, Renato Sortino, Simone Palazzo, Concetto Spampinato · 2023
  237. Wonder3D: Single Image to 3D using Cross-Domain DiffusionXiaoxiao Long, Yuan-Chen Guo, Cheng Lin, Yuan Liu, Zhiyang Dou, Lingjie Liu, Yuexin Ma, Song-Hai Zhang, Marc Habermann, Christian Theobalt, Wenping Wang · 2023
  238. RichDreamer: A Generalizable Normal-Depth Diffusion Model for Detail Richness in Text-to-3DLingteng Qiu, Guanying Chen, Xiaodong Gu, Qi Zuo, Mutian Xu, Yushuang Wu, Weihao Yuan, Zilong Dong, Liefeng Bo, Xiaoguang Han · 2023
  239. UniGS: Unified Representation for Image Generation and SegmentationLu Qi, Lehan Yang, Weidong Guo, Yu Xu, Bo Du, Varun Jampani, Ming-Hsuan Yang · 2023
  240. Meta 3D AssetGen: Text-to-Mesh Generation with High-Quality Geometry, Texture, and PBR MaterialsYawar Siddiqui, Tom Monnier, Filippos Kokkinos, Mahendra Kariya, Yanir Kleiman, Emilien Garreau, Oran Gafni, Natalia Neverova, Andrea Vedaldi, Roman Shapovalov, David Novotny · 2024
  241. JointDiT: Enhancing RGB-Depth Joint Modeling with Diffusion TransformersKwon Byung-Ki, Qi Dai, Lee Hyoseok, Chong Luo, Tae-Hyun Oh · 2025
  242. Gen3R: 3D Scene Generation Meets Feed-Forward ReconstructionJiaxin Huang, Yuanbo Yang, Bangbang Yang, Lin Ma, Yuewen Ma, Yiyi Liao · 2026
  243. VideoMatGen: PBR Materials through Joint Generative ModelingJon Hasselgren, Zheng Zeng, Milos Hasan, Jacob Munkberg · 2026
  244. Modality Forcing for Scalable Spatial GenerationBardienus Pieter Duisterhof, Deva Ramanan, Jeffrey Ichnowski, Justin Johnson, Keunhong Park · 2026
  245. Joint shape/texture representation learning for cardiovascular disease diagnosis from magnetic resonance imagingXiang Chen, Yan Xia, Erica Dall'Armellina, Nishant Ravikumar, Alejandro F Frangi · 2024
  246. PointFlow: 3D Point Cloud Generation with Continuous Normalizing FlowsGuandao Yang, Xun Huang, Zekun Hao, Ming-Yu Liu, Serge Belongie, Bharath Hariharan · 2019
  247. Visual Autoregressive Modeling: Scalable Image Generation via Next-Scale PredictionKeyu Tian, Yi Jiang, Zehuan Yuan, Bingyue Peng, Liwei Wang · 2024
  248. Non-Stationary Texture Synthesis by Adversarial ExpansionYang Zhou, Zhen Zhu, Xiang Bai, Dani Lischinski, Daniel Cohen-Or, Hui Huang · 2018
  249. Texture Fields: Learning Texture Representations in Function SpaceMichael Oechsle, Lars Mescheder, Michael Niemeyer, Thilo Strauss, Andreas Geiger · 2019
  250. Learning a Neural 3D Texture Space from 2D ExemplarsPhilipp Henzler, Niloy J. Mitra, Tobias Ritschel · 2019
  251. MaterialGAN: Reflectance Capture using a Generative SVBRDF ModelYu Guo, Cameron Smith, Miloš Hašan, Kalyan Sunkavalli, Shuang Zhao · 2020
  252. Texturify: Generating Textures on 3D Shape SurfacesYawar Siddiqui, Justus Thies, Fangchang Ma, Qi Shan, Matthias Nießner, Angela Dai · 2022
  253. TileGen: Tileable, Controllable Material Generation and CaptureXilong Zhou, Miloš Hašan, Valentin Deschaintre, Paul Guerrero, Kalyan Sunkavalli, Nima Kalantari · 2022
  254. TexFusion: Synthesizing 3D Textures with Text-Guided Image Diffusion ModelsTianshi Cao, Karsten Kreis, Sanja Fidler, Nicholas Sharp, Kangxue Yin · 2023
  255. Paint3D: Paint Anything 3D with Lighting-Less Texture Diffusion ModelsXianfang Zeng, Xin Chen, Zhongqi Qi, Wen Liu, Zibo Zhao, Zhibin Wang, Bin Fu, Yong Liu, Gang Yu · 2023
  256. FlashTex: Fast Relightable Mesh Texturing with LightControlNetKangle Deng, Timothy Omernick, Alexander Weiss, Deva Ramanan, Jun-Yan Zhu, Tinghui Zhou, Maneesh Agrawala · 2024
  257. DreamMat: High-quality PBR Material Generation with Geometry- and Light-aware Diffusion ModelsYuqing Zhang, Yuan Liu, Zhiyu Xie, Lei Yang, Zhongyuan Liu, Mengzhou Yang, Runze Zhang, Qilong Kou, Cheng Lin, Wenping Wang, Xiaogang Jin · 2024
  258. Meta 3D TextureGen: Fast and Consistent Texture Generation for 3D ObjectsRaphael Bensadoun, Yanir Kleiman, Idan Azuri, Omri Harosh, Andrea Vedaldi, Natalia Neverova, Oran Gafni · 2024
  259. Hunyuan3D 2.1: From Images to High-Fidelity 3D Assets with Production-Ready PBR MaterialTeam Hunyuan3D, Shuhui Yang, Mingxin Yang, Yifei Feng, Xin Huang, Sheng Zhang, Zebin He, Di Luo, Haolin Liu, Yunfei Zhao, Qingxiang Lin, Zeqiang Lai, Xianghui Yang, Huiwen Shi, Zibo Zhao, Bowen Zhang, Hongyu Yan, Lifu Wang, Sicong Liu, Jihong Zhang, Meng Chen, Liang Dong, Yiwen Jia, Yulin Cai, Jiaao Yu, Yixuan Tang, Dongyuan Guo, Junlin Yu, Hao Zhang, Zheng Ye, Peng He, Runzhou Wu, Shida Wei, Chao Zhang, Yonghao Tan, Yifu Sun, Lin Niu, Shirui Huang, Bojian Zheng, Shu Liu, Shilin Chen, Xiang Yuan, Xiaofeng Yang, Kai Liu, Jianchen Zhu, Peng Chen, Tian Liu, Di Wang, Yuhong Liu, Linus, Jie Jiang, Jingwei Huang, Chunchao Guo · 2025
  260. Texture Space Material DiffusionJacob Munkberg, Peter Kocsis, Jon Hasselgren · 2026
  261. SUPRA-TEX: 3D Generation with Super-Aligned TextureChen Yang, Jiemin Fang, Fanpeng Meng, Zihao Huang, Jichen Pang, Guanjun Wu, Zhikuan Bao, Qi Tian · 2026
  262. Learning Implicit Fields for Generative Shape ModelingZhiqin Chen, Hao Zhang · 2018
  263. PolyGen: An Autoregressive Generative Model of 3D MeshesCharlie Nash, Yaroslav Ganin, S. M. Ali Eslami, Peter W. Battaglia · 2020
  264. Learning Gradient Fields for Shape GenerationRuojin Cai, Guandao Yang, Hadar Averbuch-Elor, Zekun Hao, Serge Belongie, Noah Snavely, Bharath Hariharan · 2020
  265. Diffusion Probabilistic Models for 3D Point Cloud GenerationShitong Luo, Wei Hu · 2021
  266. 3D Shape Generation and Completion through Point-Voxel DiffusionLinqi Zhou, Yilun Du, Jiajun Wu · 2021
  267. DreamFusion: Text-to-3D using 2D DiffusionBen Poole, Ajay Jain, Jonathan T. Barron, Ben Mildenhall · 2022
  268. LION: Latent Point Diffusion Models for 3D Shape GenerationXiaohui Zeng, Arash Vahdat, Francis Williams, Zan Gojcic, Or Litany, Sanja Fidler, Karsten Kreis · 2022
  269. Magic3D: High-Resolution Text-to-3D Content CreationChen-Hsuan Lin, Jun Gao, Luming Tang, Towaki Takikawa, Xiaohui Zeng, Xun Huang, Karsten Kreis, Sanja Fidler, Ming-Yu Liu, Tsung-Yi Lin · 2022
  270. Point-E: A System for Generating 3D Point Clouds from Complex PromptsAlex Nichol, Heewoo Jun, Prafulla Dhariwal, Pamela Mishkin, Mark Chen · 2022
  271. MeshDiffusion: Score-based Generative 3D Mesh ModelingZhen Liu, Yao Feng, Michael J. Black, Derek Nowrouzezahrai, Liam Paull, Weiyang Liu · 2023
  272. Shap-E: Generating Conditional 3D Implicit FunctionsHeewoo Jun, Alex Nichol · 2023
  273. ProlificDreamer: High-Fidelity and Diverse Text-to-3D Generation with Variational Score DistillationZhengyi Wang, Cheng Lu, Yikai Wang, Fan Bao, Chongxuan Li, Hang Su, Jun Zhu · 2023
  274. MeshGPT: Generating Triangle Meshes with Decoder-Only TransformersYawar Siddiqui, Antonio Alliegro, Alexey Artemov, Tatiana Tommasi, Daniele Sirigatti, Vladislav Rosov, Angela Dai, Matthias Nießner · 2023
  275. Structured 3D Latents for Scalable and Versatile 3D GenerationJianfeng Xiang, Zelong Lv, Sicheng Xu, Yu Deng, Ruicheng Wang, Bowen Zhang, Dong Chen, Xin Tong, Jiaolong Yang · 2024
  276. TripoSG: High-Fidelity 3D Shape Synthesis using Large-Scale Rectified Flow ModelsYangguang Li, Zi-Xin Zou, Zexiang Liu, Dehu Wang, Yuan Liang, Zhipeng Yu, Xingchao Liu, Yuan-Chen Guo, Ding Liang, Wanli Ouyang, Yan-Pei Cao · 2025
  277. CardiacFlow: 3D+t Four-Chamber Cardiac Shape Completion and Generation via Flow MatchingQiang Ma, Qingjie Meng, Mengyun Qiao, Paul M. Matthews, Declan P. O'Regan, Wenjia Bai · 2025
  278. Text-To-4D Dynamic Scene GenerationUriel Singer, Shelly Sheynin, Adam Polyak, Oron Ashual, Iurii Makarov, Filippos Kokkinos, Naman Goyal, Andrea Vedaldi, Devi Parikh, Justin Johnson, Yaniv Taigman · 2023
  279. FILM: Frame Interpolation for Large MotionFitsum Reda, Janne Kontkanen, Eric Tabellion, Deqing Sun, Caroline Pantofaru, Brian Curless · 2022
  280. Diffusion Deformable Model for 4D Temporal Medical Image GenerationBoah Kim, Jong Chul Ye · 2022
  281. World ModelsDavid Ha, Jürgen Schmidhuber · 2018
  282. Diffusion Models Are Real-Time Game EnginesDani Valevski, Yaniv Leviathan, Moab Arar, Shlomi Fruchter · 2024
  283. Nerfies: Deformable Neural Radiance FieldsKeunhong Park, Utkarsh Sinha, Jonathan T. Barron, Sofien Bouaziz, Dan B Goldman, Steven M. Seitz, Ricardo Martin-Brualla · 2020
  284. D-NeRF: Neural Radiance Fields for Dynamic ScenesAlbert Pumarola, Enric Corona, Gerard Pons-Moll, Francesc Moreno-Noguer · 2020
  285. HyperNeRF: A Higher-Dimensional Representation for Topologically Varying Neural Radiance FieldsKeunhong Park, Utkarsh Sinha, Peter Hedman, Jonathan T. Barron, Sofien Bouaziz, Dan B Goldman, Ricardo Martin-Brualla, Steven M. Seitz · 2021
  286. HexPlane: A Fast Representation for Dynamic ScenesAng Cao, Justin Johnson · 2023
  287. Consistent4D: Consistent 360-Degree Dynamic Object Generation from Monocular VideoYanqin Jiang, Li Zhang, Jin Gao, Weimin Hu, Yao Yao · 2023
  288. Animate124: Animating One Image to 4D Dynamic SceneYuyang Zhao, Zhiwen Yan, Enze Xie, Lanqing Hong, Zhenguo Li, Gim Hee Lee · 2023
  289. DreamGaussian4D: Generative 4D Gaussian SplattingJiawei Ren, Liang Pan, Jiaxiang Tang, Chi Zhang, Ang Cao, Gang Zeng, Ziwei Liu · 2023
  290. 4DGen: Grounded 4D Content Generation with Spatial-temporal ConsistencyYuyang Yin, Dejia Xu, Zhangyang Wang, Yao Zhao, Yunchao Wei · 2023
  291. STAG4D: Spatial-Temporal Anchored Generative 4D GaussiansYifei Zeng, Yanqin Jiang, Siyu Zhu, Yuanxun Lu, Youtian Lin, Hao Zhu, Weiming Hu, Xun Cao, Yao Yao · 2024
  292. 4Diffusion: Multi-view Video Diffusion Model for 4D GenerationHaiyu Zhang, Xinyuan Chen, Yaohui Wang, Xihui Liu, Yunhong Wang, Yu Qiao · 2024
  293. L4GM: Large 4D Gaussian Reconstruction ModelJiawei Ren, Kevin Xie, Ashkan Mirzaei, Hanxue Liang, Xiaohui Zeng, Karsten Kreis, Ziwei Liu, Antonio Torralba, Sanja Fidler, Seung Wook Kim, Huan Ling · 2024
  294. SV4D: Dynamic 3D Content Generation with Multi-Frame and Multi-View ConsistencyYiming Xie, Chun-Han Yao, Vikram Voleti, Huaizu Jiang, Varun Jampani · 2024
  295. CAT4D: Create Anything in 4D with Multi-View Video Diffusion ModelsRundi Wu, Ruiqi Gao, Ben Poole, Alex Trevithick, Changxi Zheng, Jonathan T. Barron, Aleksander Holynski · 2024
  296. SV4D 2.0: Enhancing Spatio-Temporal Consistency in Multi-View Video Diffusion for High-Quality 4D GenerationChun-Han Yao, Yiming Xie, Vikram Voleti, Huaizu Jiang, Varun Jampani · 2025
  297. 4DHumanDiff: Direct Text-to-4DGS Generation for Consistent 360-Degree Dynamic HumansRenlong Wu, Haoran Chen, Yuxiang Wei, Xiaowei Jin, Wangmeng Zuo, Hui Li · 2026
  298. MEMC-Net: Motion Estimation and Motion Compensation Driven Neural Network for Video Interpolation and EnhancementWenbo Bao, Wei-Sheng Lai, Xiaoyun Zhang, Zhiyong Gao, Ming-Hsuan Yang · 2018
  299. Depth-Aware Video Frame InterpolationWenbo Bao, Wei-Sheng Lai, Chao Ma, Xiaoyun Zhang, Zhiyong Gao, Ming-Hsuan Yang · 2019
  300. AdaCoF: Adaptive Collaboration of Flows for Video Frame InterpolationHyeongmin Lee, Taeoh Kim, Tae-young Chung, Daehyun Pak, Yuseok Ban, Sangyoun Lee · 2019
  301. Softmax Splatting for Video Frame InterpolationSimon Niklaus, Feng Liu · 2020
  302. Real-Time Intermediate Flow Estimation for Video Frame InterpolationZhewei Huang, Tianyuan Zhang, Wen Heng, Boxin Shi, Shuchang Zhou · 2020
  303. FLAVR: Flow-Agnostic Video Representations for Fast Frame InterpolationTarun Kalluri, Deepak Pathak, Manmohan Chandraker, Du Tran · 2020
  304. LDMVFI: Video Frame Interpolation with Latent Diffusion ModelsDuolikun Danier, Fan Zhang, David Bull · 2023
  305. Video Interpolation with Diffusion ModelsSiddhant Jain, Daniel Watson, Eric Tabellion, Aleksander Hołyński, Ben Poole, Janne Kontkanen · 2024
  306. Perception-Oriented Video Frame Interpolation via Asymmetric BlendingGuangyang Wu, Xin Tao, Changlin Li, Wenyi Wang, Xiaohong Liu, Qingqing Zheng · 2024
  307. Frame Interpolation with Consecutive Brownian Bridge DiffusionZonglin Lyu, Ming Li, Jianbo Jiao, Chen Chen · 2024
  308. ToonCrafter: Generative Cartoon InterpolationJinbo Xing, Hanyuan Liu, Menghan Xia, Yong Zhang, Xintao Wang, Ying Shan, Tien-Tsin Wong · 2024
  309. Generative Inbetweening: Adapting Image-to-Video Models for Keyframe InterpolationXiaojuan Wang, Boyang Zhou, Brian Curless, Ira Kemelmacher-Shlizerman, Aleksander Holynski, Steven M. Seitz · 2024
  310. Motion-Aware Generative Frame InterpolationGuozhen Zhang, Yuhan Zhu, Yutao Cui, Xiaotong Zhao, Kai Ma, Limin Wang · 2025
  311. EDEN: Enhanced Diffusion for High-quality Large-motion Video Frame InterpolationZihao Zhang, Haoran Chen, Haoyu Zhao, Guansong Lu, Yanwei Fu, Hang Xu, Zuxuan Wu · 2025
  312. FB-Diff: Fourier Basis-guided Diffusion for Temporal Interpolation of 4D Medical ImagingXin You, Runze Yang, Chuyan Zhang, Zhongliang Jiang, Jie Yang, Nassir Navab · 2025
  313. TLB-VFI: Temporal-Aware Latent Brownian Bridge Diffusion for Video Frame InterpolationZonglin Lyu, Chen Chen · 2025
  314. FC-VFI: Faithful and Consistent Video Frame Interpolation for High-FPS Slow Motion Video GenerationGanggui Ding, Hao Chen, Xiaogang Xu · 2026
  315. Destination-Conditioned Adaptation with Semantic-Geometric Alignment for Generative InbetweeningZhiyu Xu, Wei Shang, Yushen Xu, Wenwen Li, Zhiyan Xu, Pengfei Zhu, Dongwei Ren · 2026
  316. Learning Latent Dynamics for Planning from PixelsDanijar Hafner, Timothy Lillicrap, Ian Fischer, Ruben Villegas, David Ha, Honglak Lee, James Davidson · 2018
  317. Dream to Control: Learning Behaviors by Latent ImaginationDanijar Hafner, Timothy Lillicrap, Jimmy Ba, Mohammad Norouzi · 2019
  318. Mastering Atari with Discrete World ModelsDanijar Hafner, Timothy Lillicrap, Mohammad Norouzi, Jimmy Ba · 2020
  319. Transformers are Sample-Efficient World ModelsVincent Micheli, Eloi Alonso, François Fleuret · 2022
  320. Mastering Diverse Domains through World ModelsDanijar Hafner, Jurgis Pasukonis, Jimmy Ba, Timothy Lillicrap · 2023
  321. GAIA-1: A Generative World Model for Autonomous DrivingAnthony Hu, Lloyd Russell, Hudson Yeo, Zak Murez, George Fedoseev, Alex Kendall, Jamie Shotton, Gianluca Corrado · 2023
  322. Learning Interactive Real-World SimulatorsSherry Yang, Yilun Du, Kamyar Ghasemipour, Jonathan Tompson, Leslie Kaelbling, Dale Schuurmans, Pieter Abbeel · 2023
  323. Diffusion for World Modeling: Visual Details Matter in AtariEloi Alonso, Adam Jelley, Vincent Micheli, Anssi Kanervisto, Amos Storkey, Tim Pearce, François Fleuret · 2024
  324. iVideoGPT: Interactive VideoGPTs are Scalable World ModelsJialong Wu, Shaofeng Yin, Ningya Feng, Xu He, Dong Li, Jianye Hao, Mingsheng Long · 2024
  325. Pandora: Towards General World Model with Natural Language Actions and Video StatesJiannan Xiang, Guangyi Liu, Yi Gu, Qiyue Gao, Yuting Ning, Yuheng Zha, Zeyu Feng, Tianhua Tao, Shibo Hao, Yemin Shi, Zhengzhong Liu, Eric P. Xing, Zhiting Hu · 2024
  326. AdaWorld: Learning Adaptable World Models with Latent ActionsShenyuan Gao, Siyuan Zhou, Yilun Du, Jun Zhang, Chuang Gan · 2025
  327. GAIA-2: A Controllable Multi-View Generative World Model for Autonomous DrivingLloyd Russell, Anthony Hu, Lorenzo Bertoni, George Fedoseev, Jamie Shotton, Elahe Arani, Gianluca Corrado · 2025
  328. Matrix-Game: Interactive World Foundation ModelYifan Zhang, Chunli Peng, Boyang Wang, Puyi Wang, Qingcheng Zhu, Fei Kang, Biao Jiang, Zedong Gao, Eric Li, Yang Liu, Yahui Zhou · 2025
  329. Training Agents Inside of Scalable World ModelsDanijar Hafner, Wilson Yan, Timothy Lillicrap · 2025
  330. Matrix-Game 3.0: Real-Time and Streaming Interactive World Model with Long-Horizon MemoryZile Wang, Zexiang Liu, Jiaxing Li, Kaichen Huang, Baixin Xu, Fei Kang, Mengyin An, Peiyu Wang, Biao Jiang, Yichen Wei, Yidan Xietian, Jiangbo Pei, Liang Hu, Boyi Jiang, Hua Xue, Zidong Wang, Haofeng Sun, Wei Li, Wanli Ouyang, Xianglong He, Yang Liu, Yangguang Li, Yahui Zhou · 2026
  331. Learning Transferable Dynamics Priors from Action to World ModelingZe Huang, Jiahui Zhang, Hairuo Liu, Chenxi Zhang, Ran Cheng, Li Zhang · 2026
  332. Generative Adversarial NetworksIan J. Goodfellow, Jean Pouget-Abadie, Mehdi Mirza, Bing Xu, David Warde-Farley, Sherjil Ozair, Aaron Courville, Yoshua Bengio · 2014
  333. Pixel Recurrent Neural NetworksAaron van den Oord, Nal Kalchbrenner, Koray Kavukcuoglu · 2016
  334. Variational Inference with Normalizing FlowsDanilo Jimenez Rezende, Shakir Mohamed · 2015
  335. Flow Matching for Generative ModelingYaron Lipman, Ricky T. Q. Chen, Heli Ben-Hamu, Maximilian Nickel, Matt Le · 2022
  336. Flow Matching for Medical Image Synthesis: Bridging the Gap Between Speed and QualityMilad Yazdani, Yasamin Medghalchi, Pooria Ashrafian, Ilker Hacihaliloglu, Dena Shahriari · 2025
  337. Which Training Methods for GANs do actually Converge?Lars Mescheder, Andreas Geiger, Sebastian Nowozin · 2018
  338. Self-Attention Generative Adversarial NetworksHan Zhang, Ian Goodfellow, Dimitris Metaxas, Augustus Odena · 2018
  339. Image Generators with Conditionally-Independent Pixel SynthesisIvan Anokhin, Kirill Demochkin, Taras Khakhulin, Gleb Sterkin, Victor Lempitsky, Denis Korzhenkov · 2020
  340. Alias-Free Generative Adversarial NetworksTero Karras, Miika Aittala, Samuli Laine, Erik Härkönen, Janne Hellsten, Jaakko Lehtinen, Timo Aila · 2021
  341. Efficient Geometry-aware 3D Generative Adversarial NetworksEric R. Chan, Connor Z. Lin, Matthew A. Chan, Koki Nagano, Boxiao Pan, Shalini De Mello, Orazio Gallo, Leonidas Guibas, Jonathan Tremblay, Sameh Khamis, Tero Karras, Gordon Wetzstein · 2021
  342. StyleGAN-XL: Scaling StyleGAN to Large Diverse DatasetsAxel Sauer, Katja Schwarz, Andreas Geiger · 2022
  343. StyleGAN-T: Unlocking the Power of GANs for Fast Large-Scale Text-to-Image SynthesisAxel Sauer, Tero Karras, Samuli Laine, Andreas Geiger, Timo Aila · 2023
  344. Scaling up GANs for Text-to-Image SynthesisMinguk Kang, Jun-Yan Zhu, Richard Zhang, Jaesik Park, Eli Shechtman, Sylvain Paris, Taesung Park · 2023
  345. Cross-scale Aligned Supervision for Training GANsSangeek Hyun, MinKyu Lee, Jae-Pil Heo · 2026
  346. Generative Modeling by Estimating Gradients of the Data DistributionYang Song, Stefano Ermon · 2019
  347. Denoising Diffusion Implicit ModelsJiaming Song, Chenlin Meng, Stefano Ermon · 2020
  348. Elucidating the Design Space of Diffusion-Based Generative ModelsTero Karras, Miika Aittala, Timo Aila, Samuli Laine · 2022
  349. DPM-Solver: A Fast ODE Solver for Diffusion Probabilistic Model Sampling in Around 10 StepsCheng Lu, Yuhao Zhou, Fan Bao, Jianfei Chen, Chongxuan Li, Jun Zhu · 2022
  350. Guiding a Diffusion Model with a Bad Version of ItselfTero Karras, Miika Aittala, Tuomas Kynkäänniemi, Jaakko Lehtinen, Timo Aila, Samuli Laine · 2024
  351. D2PO: Optimizing Diffusion Samplers via Dynamic PreferenceJinkyu Kim, Jinyoung Choi, Bohyung Han · 2026
  352. Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified FlowXingchao Liu, Chengyue Gong, Qiang Liu · 2022
  353. Building Normalizing Flows with Stochastic InterpolantsMichael S. Albergo, Eric Vanden-Eijnden · 2022
  354. Improving and generalizing flow-based generative models with minibatch optimal transportAlexander Tong, Kilian Fatras, Nikolay Malkin, Guillaume Huguet, Yanlei Zhang, Jarrid Rector-Brooks, Guy Wolf, Yoshua Bengio · 2023
  355. Flow Matching on General GeometriesRicky T. Q. Chen, Yaron Lipman · 2023
  356. Multisample Flow Matching: Straightening Flows with Minibatch CouplingsAram-Alexandre Pooladian, Heli Ben-Hamu, Carles Domingo-Enrich, Brandon Amos, Yaron Lipman, Ricky T. Q. Chen · 2023
  357. Voicebox: Text-Guided Multilingual Universal Speech Generation at ScaleMatthew Le, Apoorv Vyas, Bowen Shi, Brian Karrer, Leda Sari, Rashel Moritz, Mary Williamson, Vimal Manohar, Yossi Adi, Jay Mahadeokar, Wei-Ning Hsu · 2023
  358. Matcha-TTS: A fast TTS architecture with conditional flow matchingShivam Mehta, Ruibo Tu, Jonas Beskow, Éva Székely, Gustav Eje Henter · 2023
  359. InstaFlow: One Step is Enough for High-Quality Diffusion-Based Text-to-Image GenerationXingchao Liu, Xiwen Zhang, Jianzhu Ma, Jian Peng, Qiang Liu · 2023
  360. SiT: Exploring Flow and Diffusion-based Generative Models with Scalable Interpolant TransformersNanye Ma, Mark Goldstein, Michael S. Albergo, Nicholas M. Boffi, Eric Vanden-Eijnden, Saining Xie · 2024
  361. FlowMM: Generating Materials with Riemannian Flow MatchingBenjamin Kurt Miller, Ricky T. Q. Chen, Anuroop Sriram, Brandon M Wood · 2024
  362. Flow map matching with stochastic interpolants: A mathematical framework for consistency modelsNicholas M. Boffi, Michael S. Albergo, Eric Vanden-Eijnden · 2024
  363. Discrete Flow MatchingItai Gat, Tal Remez, Neta Shaul, Felix Kreuk, Ricky T. Q. Chen, Gabriel Synnaeve, Yossi Adi, Yaron Lipman · 2024
  364. F5-TTS: A Fairytaler that Fakes Fluent and Faithful Speech with Flow MatchingYushen Chen, Zhikang Niu, Ziyang Ma, Keqi Deng, Chunhui Wang, Jian Zhao, Kai Yu, Xie Chen · 2024
  365. One Step Diffusion via Shortcut ModelsKevin Frans, Danijar Hafner, Sergey Levine, Pieter Abbeel · 2024
  366. Mean Flows for One-step Generative ModelingZhengyang Geng, Mingyang Deng, Xingjian Bai, J. Zico Kolter, Kaiming He · 2025
  367. Frequency-Aware Flow Matching for High-Quality Image GenerationSucheng Ren, Qihang Yu, Ju He, Xiaohui Shen, Alan Yuille, Liang-Chieh Chen · 2026
  368. Low-Pass Flow MatchingFrancesco M. Ruscio, T. Konstantin Rusch · 2026
  369. Reliable Fidelity and Diversity Metrics for Generative ModelsMuhammad Ferjad Naeem, Seong Joon Oh, Youngjung Uh, Yunjey Choi, Jaejun Yoo · 2020
  370. GenEval: An Object-Focused Framework for Evaluating Text-to-Image AlignmentDhruba Ghosh, Hanna Hajishirzi, Ludwig Schmidt · 2023
  371. Aligning Synthetic Medical Images with Clinical Knowledge using Human FeedbackShenghuan Sun, Gregory M. Goldgof, Atul Butte, Ahmed M. Alaa · 2023
  372. The Unreasonable Effectiveness of Deep Features as a Perceptual MetricRichard Zhang, Phillip Isola, Alexei A. Efros, Eli Shechtman, Oliver Wang · 2018
  373. Assessing Generative Models via Precision and RecallMehdi S. M. Sajjadi, Olivier Bachem, Mario Lucic, Olivier Bousquet, Sylvain Gelly · 2018
  374. Improved Precision and Recall Metric for Assessing Generative ModelsTuomas Kynkäänniemi, Tero Karras, Samuli Laine, Jaakko Lehtinen, Timo Aila · 2019
  375. Effectively Unbiased FID and Inception Score and where to find themMin Jin Chong, David Forsyth · 2019
  376. On Buggy Resizing Libraries and Surprising Subtleties in FID CalculationGaurav Parmar, Richard Zhang, Jun-Yan Zhu · 2021
  377. DALL-Eval: Probing the Reasoning Skills and Social Biases of Text-to-Image Generative TransformersJaemin Cho, Abhay Zala, Mohit Bansal · 2022
  378. TIFA: Accurate and Interpretable Text-to-Image Faithfulness Evaluation with Question AnsweringYushi Hu, Benlin Liu, Jungo Kasai, Yizhong Wang, Mari Ostendorf, Ranjay Krishna, Noah A. Smith · 2023
  379. ImageReward: Learning and Evaluating Human Preferences for Text-to-Image GenerationJiazheng Xu, Xiao Liu, Yuchen Wu, Yuxuan Tong, Qinkai Li, Ming Ding, Jie Tang, Yuxiao Dong · 2023
  380. Pick-a-Pic: An Open Dataset of User Preferences for Text-to-Image GenerationYuval Kirstain, Adam Polyak, Uriel Singer, Shahbuland Matiana, Joe Penna, Omer Levy · 2023
  381. Human Preference Score v2: A Solid Benchmark for Evaluating Human Preferences of Text-to-Image SynthesisXiaoshi Wu, Yiming Hao, Keqiang Sun, Yixiong Chen, Feng Zhu, Rui Zhao, Hongsheng Li · 2023
  382. DreamSim: Learning New Dimensions of Human Visual Similarity using Synthetic DataStephanie Fu, Netanel Tamir, Shobhita Sundaram, Lucy Chai, Richard Zhang, Tali Dekel, Phillip Isola · 2023
  383. T2I-CompBench: A Comprehensive Benchmark for Open-world Compositional Text-to-image GenerationKaiyi Huang, Kaiyue Sun, Enze Xie, Zhenguo Li, Xihui Liu · 2023
  384. Rethinking FID: Towards a Better Evaluation Metric for Image GenerationSadeep Jayasumana, Srikumar Ramalingam, Andreas Veit, Daniel Glasner, Ayan Chakrabarti, Sanjiv Kumar · 2023
  385. Evaluating Text-to-Visual Generation with Image-to-Text GenerationZhiqiu Lin, Deepak Pathak, Baiqi Li, Jiayao Li, Xide Xia, Graham Neubig, Pengchuan Zhang, Deva Ramanan · 2024
  386. Position: All Current Generative Fidelity and Diversity Metrics are FlawedOssi Räisä, Boris van Breugel, Mihaela van der Schaar · 2025
  387. Qwen-Image-Bench: From Generation to Creation in Text-to-Image EvaluationNiantong Li, Guangzheng Hu, Weixu Qiao, Ying Ba, Qichen Hong, Shijun Shen, Jinlin Wang, Fan Zhou, Jianye Kang, Xin Shang, Ziyi He, Wei Wang, Dalin Li, Jiahao Li, Jie Zhang, Kaiyuan Gao, Kun Yan, Lihan Jiang, Ningyuan Tang, Shengming Yin, Tianhe Wu, Xiao Xu, Xiaoyue Chen, Yuxiang Chen, Yan Shu, Yanran Zhang, Yilei Chen, Yixian Xu, Zekai Zhang, Zhendong Wang, Zihao Liu, Zikai Zhou, Hongzhu Shi, Yi Wang, Bing Zhao, Hu Wei, Lin Qu, Chenfei Wu · 2026
  388. Progressive Distillation for Fast Sampling of Diffusion ModelsTim Salimans, Jonathan Ho · 2022
  389. Pseudo Numerical Methods for Diffusion Models on ManifoldsLuping Liu, Yi Ren, Zhijie Lin, Zhou Zhao · 2022
  390. DPM-Solver++: Fast Solver for Guided Sampling of Diffusion Probabilistic ModelsCheng Lu, Yuhao Zhou, Fan Bao, Jianfei Chen, Chongxuan Li, Jun Zhu · 2022
  391. Solving 3D Inverse Problems using Pre-trained 2D Diffusion ModelsHyungjin Chung, Dohoon Ryu, Michael T. McCann, Marc L. Klasky, Jong Chul Ye · 2022
  392. UniPC: A Unified Predictor-Corrector Framework for Fast Sampling of Diffusion ModelsWenliang Zhao, Lujia Bai, Yongming Rao, Jie Zhou, Jiwen Lu · 2023
  393. Latent Consistency Models: Synthesizing High-Resolution Images with Few-Step InferenceSimian Luo, Yiqin Tan, Longbo Huang, Jian Li, Hang Zhao · 2023
  394. Adversarial Diffusion DistillationAxel Sauer, Dominik Lorenz, Andreas Blattmann, Robin Rombach · 2023
  395. One-step Diffusion with Distribution Matching DistillationTianwei Yin, Michaël Gharbi, Richard Zhang, Eli Shechtman, Frédo Durand, William T. Freeman, Taesung Park · 2023
  396. DeepCache: Accelerating Diffusion Models for FreeXinyin Ma, Gongfan Fang, Xinchao Wang · 2023
  397. SDXL-Lightning: Progressive Adversarial Diffusion DistillationShanchuan Lin, Anran Wang, Xiao Yang · 2024
  398. Representation Alignment for Generation: Training Diffusion Transformers Is Easier Than You ThinkSihyun Yu, Sangkyung Kwak, Huiwon Jang, Jongheon Jeong, Jonathan Huang, Jinwoo Shin, Saining Xie · 2024
  399. Few-Step Generation via Data-Space IterationShanchuan Lin, Yansong Peng, Fu-Yun Wang, Haoqi Fan · 2026
  400. SNIPS: Solving Noisy Inverse Problems StochasticallyBahjat Kawar, Gregory Vaksman, Michael Elad · 2021
  401. Denoising Diffusion Models for Plug-and-Play Image RestorationYuanzhi Zhu, Kai Zhang, Jingyun Liang, Jiezhang Cao, Bihan Wen, Radu Timofte, Luc Van Gool · 2023
  402. Direct Diffusion Bridge using Data Consistency for Inverse ProblemsHyungjin Chung, Jeongsol Kim, Jong Chul Ye · 2023
  403. Solving Inverse Problems with Latent Diffusion Models via Hard Data ConsistencyBowen Song, Soo Min Kwon, Zecheng Zhang, Xinyu Hu, Qing Qu, Liyue Shen · 2023
  404. Score-Based Generative Models for PET Image ReconstructionImraj RD Singh, Alexander Denker, Riccardo Barbano, Željko Kereta, Bangti Jin, Kris Thielemans, Peter Maass, Simon Arridge · 2023
  405. Bayesian Conditioned Diffusion Models for Inverse ProblemsAlper Güngör, Bahri Batuhan Bilecen, Tolga Çukur · 2024
  406. Plug-and-play Diffusion Models for Image Compressive Sensing with Data Consistency ProjectionXiaodong Wang, Ping Wang, Zhangyuan Li, Xin Yuan · 2025
  407. Provable diffusion-based posterior sampling for linear inverse problems via DDIMYuchen Jiao, Na Li, Changxiao Cai, Yuxin Chen, Gen Li · 2026
  408. Deep Learning Reconstruction Enables Prospectively Accelerated Clinical Knee MRIPatricia M. Johnson, Dana J. Lin, Jure Zbontar, C. Lawrence Zitnick, Anuroop Sriram, Matthew Muckley, James S. Babb, Michael P. Recht, Florian Knoll · 2023
  409. Deep learning-enabled realistic virtual histology with ultraviolet photoacoustic remote sensing microscopyMatthew T. Martell, Nathaniel J. M. Haven, Brendyn D. Cikaluk, Brendon S. Restall, Ewan A. McAlister, Rohan Mittal, Benjamin A. Adam, Nadia Giannakopoulos, Lashan Peiris, Sveta Silverman, Jean Deschenes, Xingyu Li, Roger J. Zemp · 2023
  410. Evaluation of Digital Breast Tomosynthesis as Replacement of Full-Field Digital Mammography Using an In Silico Imaging TrialBadano, Aldo, Graff, Christian G, Badal, Andreu, Sharma, Diksha, Zeng, Rongping, Samuelson, Frank W, Glick, Stephen J, Myers, Kyle J · 2018
  411. Synthetic CT artifacts in MR-only brain radiotherapy: Clinical implementation experienceLee, Hyeri, Ayan, Ahmet S, Beyer, Sasha, Blakaj, Dukagjin, DiCostanzo, Dominic, Grecula, John C, Palmer, Joshua, Raval, Raju, Singh, Raj, Thomas, Evan, Weldon, Michael, Yang, Xiangyu, Zoller, Wesley, Gupta, Nilendu · 2026
  412. Context-specific image quality assessment for virtual histologic staining: checklist and guidelineKhan, Fadeel S., Markey, Mia K., Villa, Umberto E., Bovik, Alan C., Fox, Matthew C., Keeling, Brett H., Reichenberg, Jason S., Tunnell, James W. · 2026
  413. Personalized virtual-heart technology for guiding the ablation of infarct-related ventricular tachycardiaPrakosa, Adityo, Arevalo, Hermenegild J, Deng, Dongdong, Boyle, Patrick M, Nikolov, Plamen P, Ashikaga, Hiroshi, Blauer, Joshua JE, Ghafoori, Elyar, Park, Carolyn J, Blake, Robert C, Han, Frederick T, MacLeod, Rob S, Halperin, Henry R, Callans, David J, Ranjan, Ravi, Chrispin, Jonathan, Nazarian, Saman, Trayanova, Natalia A · 2018
  414. Assessing the Credibility of Computational Modeling and Simulation in Medical Device SubmissionsU.S. Food, Drug Administration · 2023
  415. Reporting guideline for the early stage clinical evaluation of decision support systems driven by artificial intelligence: DECIDE-AIVasey, Baptiste, Nagendran, Myura, Campbell, Bruce, Clifton, David A, Collins, Gary S, Denaxas, Spiros, Denniston, Alastair K, Faes, Livia, Geerts, Bart, Ibrahim, Mudathir, Liu, Xiaoxuan, Mateen, Bilal A, Mathur, Piyush, McCradden, Melissa D, Morgan, Lauren, Ordish, Johan, Rogers, Campbell, Saria, Suchi, Ting, Daniel S W, Watkinson, Peter, Weber, Wim, Wheatstone, Peter, McCulloch, Peter · 2022
  416. Steerable Conditional Diffusion for Out-of-Distribution Adaptation in Medical Image ReconstructionBarbano, Riccardo, Denker, Alexander, Chung, Hyungjin, Roh, Tae Hoon, Arridge, Simon, Maass, Peter, Jin, Bangti, Ye, Jong Chul · 2023
  417. Tackling Hallucination from Conditional Models for Medical Image Reconstruction with DynamicDPSKim, Seunghoi, Tregidgo, Henry F. J., Figini, Matteo, Jin, Chen, Joshi, Sarang, Alexander, Daniel C. · 2025
  418. HalluGen: Synthesizing Realistic and Controllable Hallucinations for Evaluating Image RestorationKim, Seunghoi, Tregidgo, Henry F. J., Jin, Chen, Figini, Matteo, Alexander, Daniel C. · 2025
  419. A Geometric Deep Learning Framework for Generation of Virtual Left Ventricles as GraphsSoodeh Kalaie, Andrew J. Bulpitt, Alejandro F. Frangi, Ali Gooya · 2024
  420. A Generative Shape Compositional Framework to Synthesise Populations of Virtual ChimaerasHaoran Dou, Seppo Virtanen, Nishant Ravikumar, Alejandro F. Frangi · 2022
  421. Toward trustworthy medical device in silico clinical trials: a hierarchical framework for establishing credibility and strategies for overcoming key challengesAycock, Kenneth I, Battisti, Tom, Peterson, Ashley, Yao, Jiang, Kreuzer, Steven, Capelli, Claudio, Pant, Sanjay, Pathmanathan, Pras, Hoganson, David M, Levine, Steve M, Craven, Brent A · 2024

摘要